编程模型
前置内容:安装与第一个程序。 本页把一个可运行程序拆成四个公共概念:图、字段、消息与聚合。 日常使用不需要手写 IR,也不需要指定线程安排。
一个完整例子
三个节点、五条边。每条边把源节点的温度乘上导热系数发给目标节点, 目标节点把收到的消息相加,再加上自己的 bias。
import torch
import tiga as tg

class Conductive(tg.MessagePassing):
    reducer = tg.sum()

    def edge(self, src, dst, edge):
        return edge.c * src.T

    def node(self, dst, incoming):
        return incoming + dst.b

graph = tg.Graph.from_csr(
    torch.tensor([0, 2, 3, 5], dtype=torch.int64),
    torch.tensor([0, 2, 1, 0, 1], dtype=torch.int64),
    num_src=3,
)
T = torch.tensor([1.0, 2.0, 3.0], requires_grad=True)
c = torch.tensor([2.0, 3.0, 4.0, 5.0, 6.0], requires_grad=True)
b = torch.tensor([0.1, 0.2, 0.3], requires_grad=True)

out = Conductive()(graph=graph, src={"T": T}, dst={"b": b}, edge={"c": c})
dT, dc, db = torch.autograd.grad(out.sum(), (T, c, b))
print(out.tolist())                 # approximately [11.1, 8.2, 17.3]
print(dT.tolist())                  # [7.0, 10.0, 3.0]
print(dc.tolist())                  # [1.0, 3.0, 2.0, 1.0, 2.0]
print(db.tolist())                  # [1.0, 1.0, 1.0]
tg 是 tiga 的 import 别名。输入和输出都是普通 torch.Tensor,
无需 tg.tensor() 或额外转换。
1. Graph 描述连接关系
先看箭头,再看数组
Graph 回答的是:哪些节点可以给哪个节点发消息?
它不规定消息怎么算,也不存放本例的温度或导热系数;这些数据稍后通过字段绑定。
上面的程序使用三个节点,编号为 0、1、2。箭头 2 → 0 表示节点 2 向节点 0 发消息:
箭尾是源节点 src,箭头指向目标节点 dst。
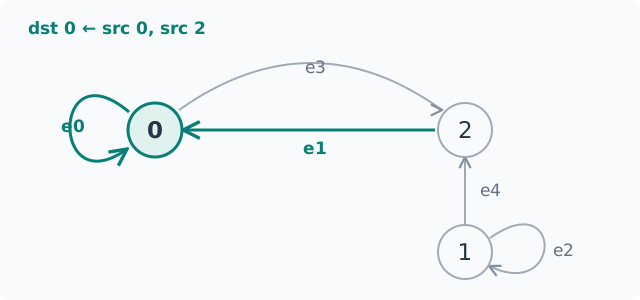
完整的五条边按存储顺序是 e0: 0 → 0、e1: 2 → 0、e2: 1 → 1、
e3: 0 → 2、e4: 1 → 2。0 → 0 与 1 → 1 是自环,
含义是把自身也算作消息来源。反向边不会自动补全,例如有 1 → 2 并不代表有 2 → 1。
同一张图,写成两个数组
CSR
不是另一种图计算,而是把这些箭头存成数组的方法。Tiga 按目标节点分组入边:
先记节点 0 的来源 [0, 2],再记节点 1 的来源 [1],最后记节点 2 的来源 [0, 1]。
拼起来就是 col_idx = [0, 2, 1, 0, 1]。
row_ptr = [0, 2, 3, 5] 记录分组边界,是数组位置,不是节点编号。
第一个目标节点从位置 0 读到位置 2 之前,第二个从 2 读到 3 之前,第三个从 3 读到 5 之前。
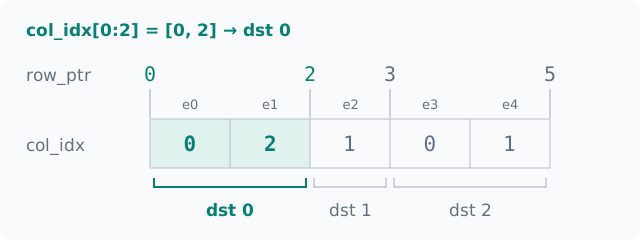
用普通 Torch 切片即可读出某个目标节点的邻居,不需要理解 IR:
row_ptr = torch.tensor([0, 2, 3, 5], dtype=torch.int64)
col_idx = torch.tensor([0, 2, 1, 0, 1], dtype=torch.int64)
dst_id = 0
begin, end = row_ptr[dst_id].item(), row_ptr[dst_id + 1].item()
sources = col_idx[begin:end].tolist()  # [0, 2]:向目标节点 0 发消息的源节点
graph = tg.Graph.from_csr(row_ptr, col_idx, num_src=3)
num_src=3 表示共有三个源节点;目标节点数量是 len(row_ptr) - 1,本例也是 3。
边数是 len(col_idx),本例为 5。相邻两个边界相等时,对应目标节点没有入边。
因此 Graph 本身只给出下面表格的前三列;最后一列还需要字段 T、c 和 edge() 的计算定义。
| 目标节点 | 入边区间 | 源节点编号 | 收到的加权消息 |
|---|---|---|---|
| 0 | [0, 2) |
[0, 2] |
2 * 1 + 3 * 3 = 11 |
| 1 | [2, 3) |
[1] |
4 * 2 = 8 |
| 2 | [3, 5) |
[0, 1] |
5 * 1 + 6 * 2 = 17 |
Graph 还可以表达其他关系,但构造器与执行覆盖是
两个问题,详见支持矩阵。
2. 字段是绑定到图上的数据
| 调用中的绑定 | 含义 | 本例长度 |
|---|---|---|
src={"T": T} |
每个源节点的温度 | 3 |
dst={"b": b} |
每个目标节点的 bias | 3 |
edge={"c": c} |
每条边的导热系数,顺序与 CSR 的边一致 | 5 |
src 与 dst 是端点角色,不一定是两组不同节点。
即使两者使用同一组节点,也可以绑定不同字段。
字段名由程序定义;T、b、c 不是编译器保留字。
3. MessagePassing 定义每条边的计算
edge() 内,src.T 是当前边的源节点温度,edge.c 是该边的系数。
一次向量化调用覆盖整张关系,无需手写遍历邻居的 Python 循环。
可选的 node() 在消息合并之后更新节点。本例将 bias 加到聚合结果,
所以最终得到约 [11.1, 8.2, 17.3]。
精确的参数规则、字段 shape、ndata 简写与允许的表达式见
MessagePassing 契约。
4. reducer 指定消息如何合并
reducer
把一个目标节点收到的多条消息合并为一个结果。
tg.sum() 求和;tg.mean() 求均值;tg.prod() 求乘积。
选择内置 reducer 即可开始,不需要先实现自定义代数。
不同 reducer 的空行行为与执行范围不同,见reducer 指南。
调用、结果与梯度
调用返回普通 torch.Tensor。torch.autograd.grad 根据同一份计算定义
获得梯度,无需手写反向函数。
本例中,节点 0 通过系数 2 和 5 影响结果,因此温度梯度是 7。
执行策略、参考求值与缓存的区别见执行与排错。 Torch 路径的计划诊断从 kernel 读取,不在 Torch 结果对象上。
下一步
- MessagePassing 契约:查字段、参数与调用规则。
- 示例:选择一个实际工作负载。
- 编译器入门:可选的内部实现阅读路径。