消息传递与图算法
输入和输出默认使用 Torch Tensor,通过 torch.autograd.grad 求导。
自定义 reducer 与 PageRank 控制流探针仍使用原生 Tensor,原因是当前 Torch
路径尚未覆盖这两类能力。以下“实测编译产物”是历史原生路径记录,
不是当前 Torch 示例运行必然生成的产物;实际计划以 kernel.explain() 为准。
静态拓扑的 MessagePassing 程序,以及一个固定迭代次数的图算法探针。 编译器生成关系遍历及其 VJP;用户只需编写 UDF。 消息传递指南介绍了该接口。每节只展示最核心的 代码片段;完整可运行的程序在折叠的源码块中,点开即可查看。
python examples/message_passing_autograd.pypython examples/gcn.pypython examples/diffusion.pypython examples/custom_reducer.pypython examples/compiler_probes/pagerank.py
GCN 聚合
是什么。 一个图卷积网络(GCN)层:图中每个节点携带一个特征向量 (这里 F = 2),该层把每个节点的特征替换为指向它的节点的特征向量 之和,每条边各乘以一个标量权重。用线性代数的语言来说,这是一次加权的 稀疏矩阵–矩阵乘法(SpMM):加权邻接矩阵乘以特征矩阵。示例还将所有输出 之和对特征和权重反向求导。
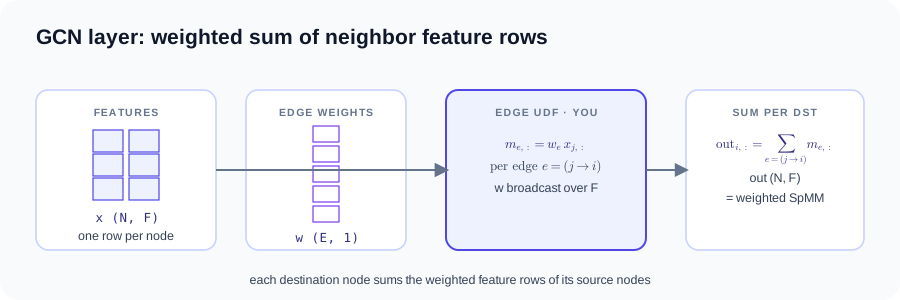
Torch 示例支持多特征聚合、边广播和自动梯度,张量形状与 GCN 一致。GCN 层是 用户代码,而不是库算子。
class WeightedFeatureAggregation(tg.MessagePassing):
    reducer = tg.sum()

    def edge(self, src, dst, edge):
        # message on edge e=(j→i): weight[e] * x[j, :] — (F,) per edge
        return edge.weight * src.x


output = WeightedFeatureAggregation()(
    graph=graph, src={"x": x}, dst={}, edge={"weight": weight})  # (N, F)
完整源码:examples/gcn.py(可直接运行)
"""feature MessagePassing and automatic gradients (SpMM shape)."""

import torch
import tiga as tg


# 3 nodes, 5 edges: 0→0, 2→0, 1→1, 0→2, 1→2
row_ptr = torch.tensor([0, 2, 3, 5], dtype=torch.int64)        # (N+1,)
col_idx = torch.tensor([0, 2, 1, 0, 1], dtype=torch.int64)     # (E,)
graph = tg.Graph.from_csr(row_ptr, col_idx, num_src=3, validate="full")

x = torch.tensor(
    [[1.0, 2.0], [3.0, 4.0], [5.0, 6.0]], requires_grad=True)        # (N, F)
# [E, 1] broadcasts over the feature axis without changing graph semantics.
weight = torch.tensor(
    [[0.5], [1.0], [2.0], [1.5], [0.25]], requires_grad=True)        # (E, 1)


class WeightedFeatureAggregation(tg.MessagePassing):
    reducer = tg.sum()

    def edge(self, src, dst, edge):
        # message on edge e=(j→i): weight[e] * x[j, :] — (F,) per edge
        return edge.weight * src.x


output = WeightedFeatureAggregation()(
    graph=graph, src={"x": x}, dst={}, edge={"weight": weight})  # (N, F)

dx, dweight = torch.autograd.grad(output.sum(), (x, weight))
# d x[j, :] = Σ weight[e] over edges e out of j (broadcast over F)
# d weight[e] = Σ_f x[src(e), f]
本机编译产物(Ryzen 7 255 · RTX 5070 Ti 实测)
### WeightedFeatureAggregation
backend: cpu:0
provider: tiga-runtime
lowering: gf-tensor-relation-autograd
passes: bind-static-csr-snapshot, capture-message-passing-udf, analyze-reducer-algebra, lower-csr-to-gather-segment, fuse-edge-node-regions
remark: [planning] edge/node UDFs remain in the differentiable Tensor DAG
remark: [planning] gf-tensor-vjp generates CSR gather/segment-sum adjoints
remark: [planning] reducer lowering: builtin-additive-state
variant cache: hits=0, misses=1
### WeightedFeatureAggregation
backend: cuda:0
provider: tiga-runtime
lowering: gf-tensor-relation-autograd
passes: bind-static-csr-snapshot, capture-message-passing-udf, analyze-reducer-algebra, lower-csr-to-gather-segment, fuse-edge-node-regions
remark: [planning] edge/node UDFs remain in the differentiable Tensor DAG
remark: [planning] gf-tensor-vjp generates CSR gather/segment-sum adjoints
remark: [planning] reducer lowering: builtin-additive-state
variant cache: hits=0, misses=1
定向扩散
是什么。 扩散:存储在图的节点上的某个量(热量、浓度)沿边从较大值 流向较小值,直到趋于均匀。流入一个节点的通量,是其所有入边上“边的 电导率乘以邻居值与自身值之差”的总和。示例在一个 4 节点环上推进一个 显式欧拉步——每个节点按小时间步长 Δt 乘以净通量移动——环上每个节点 都与两个邻居交换数值。
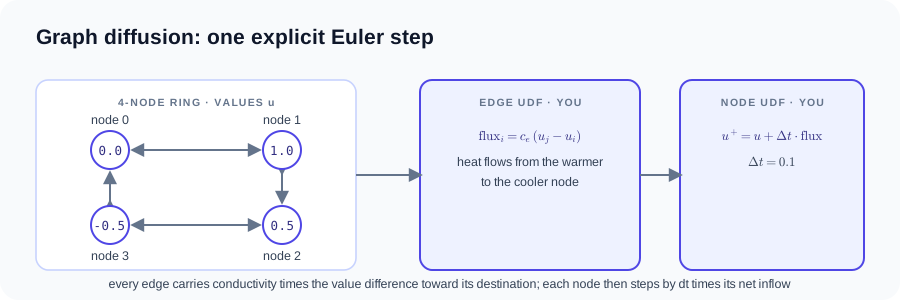
字段 u 和边电导率都会获得编译器生成的梯度。
class Diffusion(tg.MessagePassing):
    reducer = tg.sum()

    def edge(self, src, dst, edge):
        # message on edge e=(j→i): conductivity[e] * (u[j] − u[i]) — scalar
        return edge.conductivity * (src.u + (-1.0) * dst.u)

    def node(self, dst, flux, dt):
        # flux: (N,) reduced messages; dt arrives from the call site
        return dst.u + dt * flux


next_u = Diffusion()(
    graph=graph,
    ndata={"u": u},  # homogeneous graph: one declaration, both roles
    edge={"conductivity": conductivity},
    dt=0.1,
)  # (N,)
完整源码:examples/diffusion.py(可直接运行)
"""differentiable diffusion UDF on an explicit CSR stencil."""

import torch
import tiga as tg


# 4 nodes, 8 edges: dst i gathers from two sources each
nodes = 4
row_ptr = torch.tensor([0, 2, 4, 6, 8], dtype=torch.int64)    # (N+1,)
col_idx = torch.tensor([3, 1, 0, 2, 1, 3, 2, 0], dtype=torch.int64)  # (E,)
graph = tg.Graph.from_csr(row_ptr, col_idx, num_src=nodes, validate="full")

u = torch.tensor([0.0, 1.0, 0.5, -0.5], requires_grad=True)         # (N,)
conductivity = torch.tensor([1.0] * 8, requires_grad=True)          # (E,)


class Diffusion(tg.MessagePassing):
    reducer = tg.sum()

    def edge(self, src, dst, edge):
        # message on edge e=(j→i): conductivity[e] * (u[j] − u[i]) — scalar
        return edge.conductivity * (src.u + (-1.0) * dst.u)

    def node(self, dst, flux, dt):
        # flux: (N,) reduced messages; dt arrives from the call site
        return dst.u + dt * flux


next_u = Diffusion()(
    graph=graph,
    ndata={"u": u},  # homogeneous graph: one declaration, both roles
    edge={"conductivity": conductivity},
    dt=0.1,
)  # (N,)
# flux = [0.5, -1.5, -0.5, 1.5]

du, d_conductivity = torch.autograd.grad(next_u.sum(), (u, conductivity))
# every node has in-degree = out-degree = 2, so the flux terms cancel in du
# d conductivity[e] = dt · (u[src(e)] − u[dst(e)])
本机编译产物(Ryzen 7 255 · RTX 5070 Ti 实测)
### Diffusion
backend: cpu:0
provider: tiga-runtime
lowering: gf-tensor-relation-autograd
passes: bind-static-csr-snapshot, capture-message-passing-udf, analyze-reducer-algebra, lower-csr-to-gather-segment, fuse-edge-node-regions
remark: [planning] edge/node UDFs remain in the differentiable Tensor DAG
remark: [planning] gf-tensor-vjp generates CSR gather/segment-sum adjoints
remark: [planning] reducer lowering: builtin-additive-state
variant cache: hits=0, misses=1
### Diffusion
backend: cuda:0
provider: tiga-runtime
lowering: gf-tensor-relation-autograd
passes: bind-static-csr-snapshot, capture-message-passing-udf, analyze-reducer-algebra, lower-csr-to-gather-segment, fuse-edge-node-regions
remark: [planning] edge/node UDFs remain in the differentiable Tensor DAG
remark: [planning] gf-tensor-vjp generates CSR gather/segment-sum adjoints
remark: [planning] reducer lowering: builtin-additive-state
variant cache: hits=0, misses=1
可微分的 MessagePassing UDF
是什么。 本示例把节点看作携带温度和 偏置的点,把边看作导体:每条边将自己的电导率乘以源节点的温度,转发给 目标节点,目标节点再加上自身的偏置。随后示例求总输出对每个输入的 导数,以向量–雅可比积(VJP)的形式返回——即前向计算的伴随——全程 无需手写任何反向代码。
该示例计算带有目标节点偏置的传导聚合,
然后通过 torch.autograd.grad 对三个 Torch 输入求 sum(out) 的导数。
仅原生接口支持的 checkpoint 策略检查独立放在
python examples/native_checkpoint.py。
class ConductiveAggregation(tg.MessagePassing):
    reducer = tg.sum()

    def edge(self, src, dst, edge):
        # message on edge e=(j→i): conductivity[e] * temperature[j] — scalar
        return edge.conductivity * src.temperature

    def node(self, dst, incoming):
        # incoming: (N,) reduced messages; dst.bias: (N,)
        return incoming + dst.bias


kernel = ConductiveAggregation()
output = kernel(  # (N,)
    graph=graph,
    src={"temperature": temperature},
    dst={"bias": bias},
    edge={"conductivity": conductivity},
)
完整源码:examples/message_passing_autograd.py(可直接运行)
"""Differentiable MessagePassing UDF with no user-written backward."""

import torch
import tiga as tg


# 3 nodes, 5 edges: 0→0, 2→0, 1→1, 0→2, 1→2
row_ptr = torch.tensor([0, 2, 3, 5], dtype=torch.int64)        # (N+1,)
col_idx = torch.tensor([0, 2, 1, 0, 1], dtype=torch.int64)     # (E,)
graph = tg.Graph.from_csr(row_ptr, col_idx, num_src=3, validate="full")

temperature = torch.tensor([1.0, 2.0, 3.0], requires_grad=True)             # (N,)
conductivity = torch.tensor([2.0, 3.0, 4.0, 5.0, 6.0], requires_grad=True)  # (E,)
bias = torch.tensor([0.1, 0.2, 0.3], requires_grad=True)                    # (N,)


class ConductiveAggregation(tg.MessagePassing):
    reducer = tg.sum()

    def edge(self, src, dst, edge):
        # message on edge e=(j→i): conductivity[e] * temperature[j] — scalar
        return edge.conductivity * src.temperature

    def node(self, dst, incoming):
        # incoming: (N,) reduced messages; dst.bias: (N,)
        return incoming + dst.bias


kernel = ConductiveAggregation()
output = kernel(  # (N,)
    graph=graph,
    src={"temperature": temperature},
    dst={"bias": bias},
    edge={"conductivity": conductivity},
)
# out = [2·1 + 3·3 + 0.1,  4·2 + 0.2,  5·1 + 6·2 + 0.3]

loss = output.sum()                                                      # scalar
d_temperature, d_conductivity, d_bias = torch.autograd.grad(
    loss, (temperature, conductivity, bias))
# d temperature[j] = Σ conductivity[e] over edges e out of j
# d conductivity[e] = temperature[src(e)]

# Native-only compiler checkpoint inspection is a separate advanced example:
# examples/native_checkpoint.py

if __name__ == "__main__":
    print(output.tolist())
    print(d_temperature.tolist())
本机编译产物(Ryzen 7 255 · RTX 5070 Ti 实测)
### ConductiveAggregation
backend: cpu:0
provider: tiga-runtime
lowering: gf-tensor-relation-autograd
passes: bind-static-csr-snapshot, capture-message-passing-udf, analyze-reducer-algebra, lower-csr-to-gather-segment, fuse-edge-node-regions
remark: [planning] edge/node UDFs remain in the differentiable Tensor DAG
remark: [planning] gf-tensor-vjp generates CSR gather/segment-sum adjoints
remark: [planning] reducer lowering: builtin-additive-state
variant cache: hits=0, misses=1
### ConductiveAggregation
backend: cuda:0
provider: tiga-runtime
lowering: gf-tensor-relation-autograd
passes: bind-static-csr-snapshot, capture-message-passing-udf, analyze-reducer-algebra, lower-csr-to-gather-segment, fuse-edge-node-regions
remark: [planning] edge/node UDFs remain in the differentiable Tensor DAG
remark: [planning] gf-tensor-vjp generates CSR gather/segment-sum adjoints
remark: [planning] reducer lowering: builtin-additive-state
variant cache: hits=0, misses=1
用户自定义 reducer
是什么。 当机器唯一能并行做的事是两两合并值时,如何计算均值。诀窍是 携带一个二元组——累计和与元素计数——而不是单个数:每个值 v 变成 (v, 1),两个二元组按分量相加合并,最后一次除法把累积的二元组变成均值。 由于合并满足结合律和交换律,合并顺序——也即并行调度——是自由的。
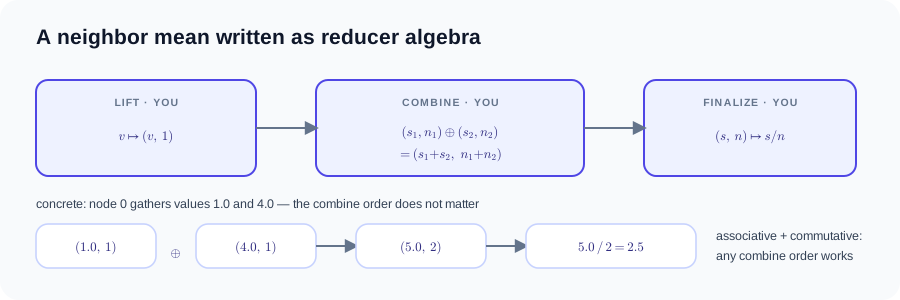
各方法分别在哪一步执行——下面用普通 Python 循环展示同一计算:
for i in range(num_dst):                 # per destination node
    state = identity()                   # (0.0, 0.0) — before its edges
    for e in edges_into(i):
        message = edge(src, dst, edge)   # the edge() UDF, here src.value
        state = combine(state, lift(message))
    out[i] = finalize(state)             # s / n — after its edges

# node 0 traces:  (0.0, 0.0) → combine((0.0,0.0), lift(1.0)) = (1.0, 1)
#                          → combine((1.0,1),   lift(4.0))   = (5.0, 2)
#                          → finalize((5.0, 2)) = 2.5
上面的循环展示的是逻辑顺序,即一次左折叠。由于该代数声明了结合律和 交换律,编译器可以按任意顺序、或以树形方式合并——这正是并行调度可以 自由安排的原因。编译器证明元组状态按分量可加,对四个区域做 lowering, 并生成穿过均值的反向传播。
class Mean(tg.Reducer):
    associative = True
    commutative = True

    def identity(self):
        return 0.0, 0.0  # (sum, count)

    def lift(self, value):
        return value, 1.0

    def combine(self, left, right):
        return left[0] + right[0], left[1] + right[1]

    def finalize(self, state):
        return state[0] / state[1]


class NeighborMean(tg.MessagePassing):
    reducer = Mean()

    def edge(self, src, dst, edge):
        # staged reducer item: (src.value[j], 1) per edge
        return self.reducer(src.value)


kernel = NeighborMean()
output = kernel(graph=graph, src={"value": values}, dst={})  # (N,)
完整源码:examples/custom_reducer.py(可直接运行)
"""Advanced custom reducer: this algebra currently needs the native runtime."""

import tiga as tg


# 3 nodes, 5 edges: 0→0, 2→0, 1→1, 0→2, 1→2
row_ptr = tg.tensor([0, 2, 3, 5], dtype=tg.int64)    # (N+1,)
col_idx = tg.tensor([0, 2, 1, 0, 1], dtype=tg.int64)  # (E,)
graph = tg.Graph.from_csr(row_ptr, col_idx, num_src=3, validate="full")
values = tg.tensor([1.0, 2.0, 4.0], requires_grad=True)          # (N,)


class Mean(tg.Reducer):
    associative = True
    commutative = True

    def identity(self):
        return 0.0, 0.0  # (sum, count)

    def lift(self, value):
        return value, 1.0

    def combine(self, left, right):
        return left[0] + right[0], left[1] + right[1]

    def finalize(self, state):
        return state[0] / state[1]


class NeighborMean(tg.MessagePassing):
    reducer = Mean()

    def edge(self, src, dst, edge):
        # staged reducer item: (src.value[j], 1) per edge
        return self.reducer(src.value)


kernel = NeighborMean()
output = kernel(graph=graph, src={"value": values}, dst={})  # (N,)

gradient = tg.autograd.grad(output.sum(), values)
# d values[j] = Σ 1/degree(dst(e)) over edges e out of j

# Inspect the selected plan: kernel.explain()


def main() -> None:
    return output, gradient


if __name__ == "__main__":
    main()
本机编译产物(Ryzen 7 255 · RTX 5070 Ti 实测)
### NeighborMean
backend: cpu:0
provider: tiga-runtime
lowering: gf-tensor-relation-autograd
passes: bind-static-csr-snapshot, capture-message-passing-udf, analyze-reducer-algebra, lower-csr-to-gather-segment, fuse-edge-node-regions
remark: [planning] edge/node UDFs remain in the differentiable Tensor DAG
remark: [planning] gf-tensor-vjp generates CSR gather/segment-sum adjoints
remark: [planning] reducer lowering: proved-componentwise-additive-udf
variant cache: hits=0, misses=1
### NeighborMean
backend: cuda:0
provider: tiga-runtime
lowering: gf-tensor-relation-autograd
passes: bind-static-csr-snapshot, capture-message-passing-udf, analyze-reducer-algebra, lower-csr-to-gather-segment, fuse-edge-node-regions
remark: [planning] edge/node UDFs remain in the differentiable Tensor DAG
remark: [planning] gf-tensor-vjp generates CSR gather/segment-sum adjoints
remark: [planning] reducer lowering: proved-componentwise-additive-udf
variant cache: hits=0, misses=1
固定迭代的 PageRank 探针
是什么。 PageRank:按重要性为网页排序的算法。每个页面以相等的 rank 开始;每一轮中,页面把自己的 rank 均分给它的出链,并收集经入链 到达的 rank,再与一个模拟随机跳转的小常数 (1 − damping)/N 混合。没有 出链的页面(悬挂节点)会让 rank 泄漏出系统,因此要把这部分 rank 均匀 重新分配给所有页面。本例:4 个页面、3 条链接、阻尼系数 0.85、20 轮。
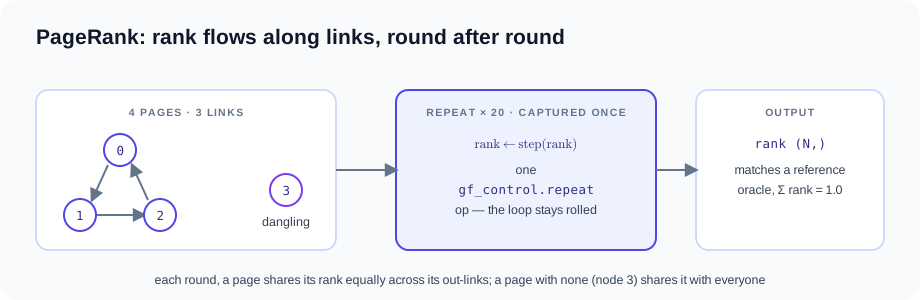
迭代是 @tg.jit 之下的普通 Python for 循环;20 次迭代被一次性捕获
为单个 gf_control.repeat 算子——循环保持卷起,不做展开(测试会对照
一个框架无关的参考实现,验证这一 IR 形状和 rank 数值)。这是编译器
探针,不是面向特定负载的核心算子,也不构成性能声明。
    class PageRankStep(tg.MessagePassing):
        reducer = tg.sum()

        def edge(self, src, dst, edge):
            return src.rank * edge.inverse_out_degree

        def node(self, dst, incoming, damping, base):
            return base + damping * incoming

    step = PageRankStep()

    @tg.jit
    def iterate(rank, inverse_out_degree, dangling, damping, iterations):
        for _ in range(iterations):
            dangling_mass = (rank * dangling).sum()
            base = (1.0 - damping) / 4.0 + damping * dangling_mass / 4.0
            rank = step(
                graph=graph,
                src={"rank": rank},
                dst={},
                edge={"inverse_out_degree": inverse_out_degree},
                damping=damping,
                base=base,
            )
        return rank

    rank = iterate(rank, inverse_out_degree, dangling, damping, iterations)
完整源码:examples/compiler_probes/pagerank.py(可直接运行)
"""PageRank as a compiler probe, not a core Tiga algorithm."""

from __future__ import annotations

import tiga as tg


def run(iterations: int = 20, damping: float = 0.85):
    # Incoming CSR for 0 <- 2, 1 <- 0, 2 <- 1 and dangling vertex 3.
    row_ptr = tg.tensor([0, 1, 2, 3, 3], dtype=tg.int64)      # (N+1,)
    col_idx = tg.tensor([2, 0, 1], dtype=tg.int64)            # (E,)
    graph = tg.Graph.from_csr(
        row_ptr, col_idx, num_src=4, validate="full")

    rank = tg.tensor([0.25] * 4, dtype=tg.float32)            # (N,)
    inverse_out_degree = tg.tensor([1.0, 1.0, 1.0], dtype=tg.float32)  # (E,)
    dangling = tg.tensor([0.0, 0.0, 0.0, 1.0], dtype=tg.float32)       # (N,)

    class PageRankStep(tg.MessagePassing):
        reducer = tg.sum()

        def edge(self, src, dst, edge):
            return src.rank * edge.inverse_out_degree

        def node(self, dst, incoming, damping, base):
            return base + damping * incoming

    step = PageRankStep()

    @tg.jit
    def iterate(rank, inverse_out_degree, dangling, damping, iterations):
        for _ in range(iterations):
            dangling_mass = (rank * dangling).sum()
            base = (1.0 - damping) / 4.0 + damping * dangling_mass / 4.0
            rank = step(
                graph=graph,
                src={"rank": rank},
                dst={},
                edge={"inverse_out_degree": inverse_out_degree},
                damping=damping,
                base=base,
            )
        return rank

    rank = iterate(rank, inverse_out_degree, dangling, damping, iterations)

    canonical_ir = rank.mlir()
    actual = rank.tolist()

    expression_nodes = sum(
        line.startswith("%") for line in rank.expression().splitlines())
    return actual, expression_nodes, canonical_ir


if __name__ == "__main__":
    run()

# Inspect: rank.expression(), rank.mlir()  (via run()'s return values)
本机编译产物(Ryzen 7 255 · RTX 5070 Ti 实测)
### PageRankStep
backend: cpu:0
provider: tiga-runtime
lowering: gf-tensor-relation-autograd
passes: bind-static-csr-snapshot, capture-message-passing-udf, analyze-reducer-algebra, lower-csr-to-gather-segment, fuse-edge-node-regions
remark: [planning] edge/node UDFs remain in the differentiable Tensor DAG
remark: [planning] gf-tensor-vjp generates CSR gather/segment-sum adjoints
remark: [planning] reducer lowering: builtin-additive-state
variant cache: hits=0, misses=1
### PageRankStep
backend: cuda:0
provider: tiga-runtime
lowering: gf-tensor-relation-autograd
passes: bind-static-csr-snapshot, capture-message-passing-udf, analyze-reducer-algebra, lower-csr-to-gather-segment, fuse-edge-node-regions
remark: [planning] edge/node UDFs remain in the differentiable Tensor DAG
remark: [planning] gf-tensor-vjp generates CSR gather/segment-sum adjoints
remark: [planning] reducer lowering: builtin-additive-state
variant cache: hits=0, misses=1