动态图加速
动态图不是某一种存储格式,而是一条逻辑关系——邻居集合依赖不断变化的数据。
Tiga 让这条关系在 IR 里以语义形式保留足够久,再来决定边应当生成、
缓存、增量修复、分区还是分页。物化 CSR 只是一种合法的实现方式,而不是
Graph.radius 或 Graph.knn 的默认含义。
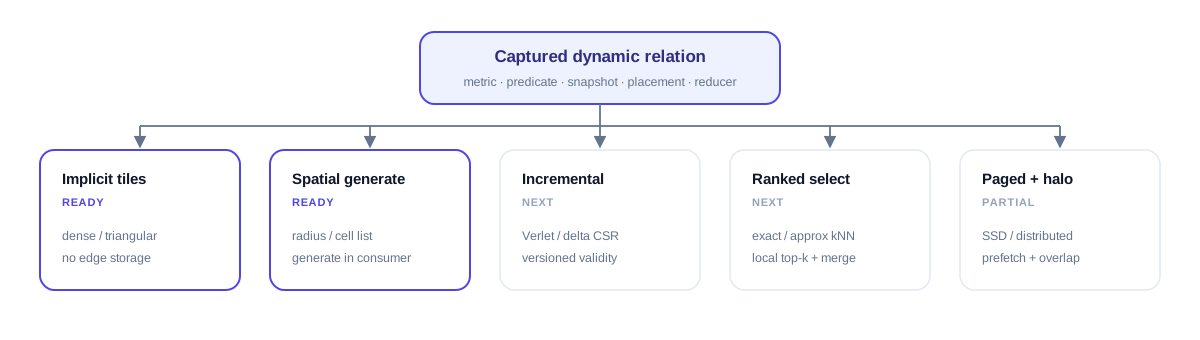
打开完整尺寸的 SVG。实现方式是编译器的选择,而不是另一种用户 Graph 类型。
实现方式矩阵
本表汇总原生与 Torch 适配器实现,以及明确标为规划中的方案。生成式 CUDA 遍历不是原生 MessagePassing 的默认实现:原生 radius 当前消费物化 CSR,原生 kNN/dense MessagePassing 尚不支持。参见覆盖范围。
| 关系与生命周期 | 物理结构 | 编译器机会 | 最佳场景 | 当前状态 |
|---|---|---|---|---|
| 固定网格 stencil | 由网格尺寸和偏移生成的 CSR | 字段更新时复用拓扑;只按偏移遍历是独立的优化方向 | 规则网格滤波与局部更新 | CPU/CUDA 构造与 Torch 执行可用;当前物化 CSR |
| 稠密笛卡尔或三角 | 无边数组;query/source tile | 融合消息、online reducer 与数值收缩;状态保留在寄存器/共享内存中 | attention、输出远小于关系规模的全对 kernel | 可执行且已完成基准测试 |
| 欧氏半径,每次重建 | 排序网格目录加非空网格区间 | 在消费方内部生成候选、按距离拒绝,避免 CSR/距离/消息张量 | 网格占据数有界的低维粒子 | 2D/3D 默认度量可执行,含周期边界盒/斜切情形 |
| 有界运动的半径 | 网格目录或邻居列表加 skin 层 | 位移证书有效期间复用;仅在失效时重建 | 运动连贯的分子动力学与时间步进 | 已有快照/版本复用;完整的 Verlet 失效策略是下一步工作 |
| 精确 kNN | 候选 tile 加分层局部 top-k 与合并 | 融合距离、选择与消费;M0 选择状态保持在寄存器内 | 精确的低/中维搜索 | FP32 平方欧氏 M0 可执行;三道严格门禁通过;大 k/度量/spill 仍为部分完成 |
| 近似 kNN | IVF/HNSW/树目录加精化关系 | 将 probe/refine 编译为嵌套的生成式关系,并把召回率作为契约的一部分 | 无需精确全对的高维搜索 | 已规划;无性能声明 |
| 可变边流 | 不可变 CSR 基图加排序增量段/墓碑标记 | 融合基图与增量遍历、异步压缩、快照版本化 | 边更新为小批量的时序/社交图 | 已规划 |
| 偏斜的物化图 | 度数 CDF 工作表与分块的高度数尾部 | 短行与拆分行使用不同调度;不相交的输出所有权避免原子操作 | 幂律社交图 | 可执行且已完成基准测试 |
| SSD/分布式图 | offload 使用分页 CSR;分布式使用目标分片与 halo 计划 | 分页读取拓扑,或先交换 halo 再计算本地行 | 大型存储图与空间分区 | 单设备分页和双主机 NCCL 已分别测量,见实验 |
因此,“动态”至少有三个相互独立的维度:
- 拓扑变化: 无、有界运动、批量增量或完全重建;
- 关系密度: 稀疏物化、稀疏生成或隐式稠密;
- 驻留方式: 单设备、主机后备、SSD 分页或分布式分片。
这些事实属于被捕获的关系及其快照令牌,不应以手写的
cache(..., space="shared") 提示散落在每个用户 kernel 中。
固定规则也是生成式关系
Graph.stencil(dims, offsets=None, periodic=False) 按“目标坐标 + 偏移”确定源节点,
不需要位置数组或距离搜索。节点取值变化不会改变这张图的拓扑。
当前构造器仍物化 CSR,不等同于只按偏移执行的无边数组 kernel。
五点网格示例展示了索引、周期边界与 Torch 梯度。
省略 offsets 默认使用 tg.stencil.von_neumann();也支持 tg.stencil.moore() 与手写偏移。
详见邻域 MACRO
及 radius/kNN 自定义距离。
生成式半径遍历
对于默认欧氏半径图,编译器可能将其 lowering 为
%%{init: {'theme':'base', 'themeVariables': {'primaryColor':'#eef2ff','primaryBorderColor':'#4f46e5','primaryTextColor':'#312e81','lineColor':'#64748b','fontFamily':'Arial'}}}%%
flowchart LR
    A[目标粒子] --> B[cell 坐标] --> C[相邻非空 cell]
    C --> D[候选源粒子] --> E[精确 metric / select 谓词]
    E --> F[消息 + reducer]
在生成式 CUDA 路径中,目录开销为 O(N + cells),边不必以数组形式
驻留在全局内存中。构建/消费融合
消除了四个原本需要物化的数组:行指针、列索引、边距离与消息。
存档动态基准对比了这种构建与消费路径,以及显式构图再聚合的实现。
自定义度量需要已证明的宽相(broad-phase)界才能使用此路径。否则 Tiga
保留精确语义并选择通用回退。select UDF 可以剔除候选,但不能绕过半径谓词。
CUDA hash directory 与 Warp 同口径比较
连续 FP32、2D/3D、非周期的欧氏输入使用固定大小的
hash grid。Torch 编译的预处理计算 bucket key,
厂商 sort/search 构建各 bucket 的范围;Tiga 通过 Domain/Iter/Kernel IR 生成邻居遍历、
精确距离判断和标量 distance-weighted sum。bucket 回绕是哈希,不是周期几何边界:
碰撞只增加候选,不会直接增加被接受的边。周期几何继续使用独立的 dense directory,
自定义 metric 保留精确回退。该路径的支持范围不包含通用 EdgeNN fusion;backward 仍可能物化 CSR。
目录快照和普通输出独立持有 storage,detach() 别名不会被下次调用覆盖;
显式复用仅限内部索引 scratch。inference Tensor 没有版本计数器,数据相关缓存保守重建。
2026-09-20 验证环境:RTX 5070 Ti、Torch 2.11.0+cu128、Triton 3.6.0、Warp 1.9.1。
输入为 131,072 个均匀分布的 3D 点,约 4.02M 条有向边、单个 FP32 feature;
操作为 sum(distance * x),排除自身且不截断邻居。两个坐标快照的全部输出均与
独立物化参考一致,最大绝对误差低于 5e-7。
| 实现 | 构建索引(ms) | 固定索引计算(ms) | 重建并计算(ms) | buffer 分配峰值(MiB) |
|---|---|---|---|---|
| Tiga dense-directory 基线 | 0.4030 | 1.2374 | 1.6968 | 21.68 |
| Tiga hash-directory | 0.1808 | 0.3218 | 0.5626 | 16.00 |
| Warp hash grid | 0.0620 | 0.2469 | 0.2905 | 8.78 |
本例重建并计算比 dense 基线快约 3.02×,但 Warp 仍更快,分配内存也更少。 这不是 Tiga 普遍快于 Warp radius search 的证据;早期 EdgeNN 图表的操作和计时边界不同。
每个 provider 在独立进程运行,每阶段 5 次预热、30 个样本;表中是同步后的墙钟中位数。 两方的坐标替换都在计时外。固定索引阶段关闭 Tiga 的自适应 CSR 缓存,确保双方都查询 空间索引。分配峰值包括输入与 provider scratch,不包括 driver/module 或 allocator 保留空闲块;Warp 使用其内存池高水位与固定 Torch 输入之和作为上界。 CUDA event 样本、两个输入快照 hash 与源码 hash 均在原始记录中: Tiga、 dense 基线、 Warp。
安装仅用于 benchmark 的 warp-lang==1.9.1 后运行
同口径 benchmark 源码:
for provider in tiga tiga-dense warp; do
  python benchmarks/graph_operations/warp_radius.py --provider "$provider" \
    --nodes 131072 --repeats 30 --output "output/radius-$provider.json"
done
该 benchmark 与普通安装独立,Tiga 不依赖 Warp。
精确 kNN 需要分层选择
精确 kNN 是一种 可执行的排序关系 lowering,而非库调用 dispatch;实测门禁见基准测试结果。 编译器路径为:
%%{init: {'theme':'base', 'themeVariables': {'primaryColor':'#eef2ff','primaryBorderColor':'#4f46e5','primaryTextColor':'#312e81','lineColor':'#64748b','fontFamily':'Arial'}}}%%
flowchart LR
    A[query tile × 候选 tile] --> B[metric UDF] --> C[局部 top-k 选择]
    C --> D[分层归并] --> E[选中边的消息 / reducer]
这些步骤由 provider 中立的 Domain/Iter/Kernel IR 表示,核心生成 TTIR——
不存在以负载命名的 Python/Triton kernel。M0 将物理键状态保持在
next_pow2(k),屏蔽超出精确语义 k 的 lane,因此无需全局暂存即可支持所有
k≤64。更大的 k 仍需要带内存预算的多任务 spill 计划;只有当精确性可以被
证明时才会选择空间目录。近似搜索是另一份公开契约,必须同时报告召回率与速度。
幂律图的负载均衡
每行一个线程块会在短行上浪费大部分 lane,并在 hub 节点上停顿。Tiga 记录度数分布并选择混合调度:
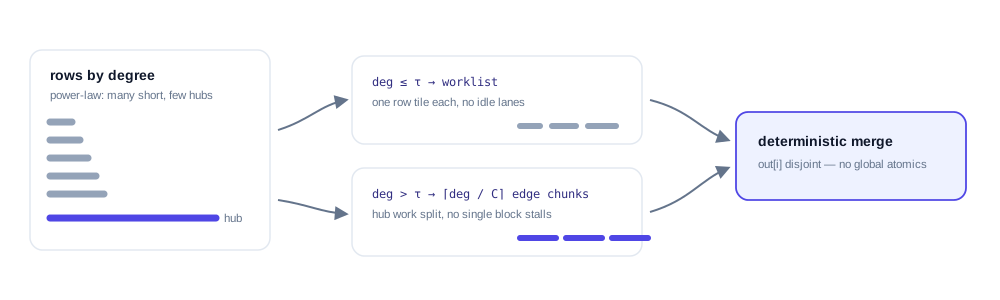
对于度数为 d_i 的行 i,给定块大小 C 与度数阈值 tau,调度及其
保持的归并语义为:
- 短行与中等行进入度数 CDF 工作表,使用按行特化的 tile;
- 高度数行拆分为固定大小的边块;
- 各块的部分结果通过确定性的任务依赖完成最终归并;
- 目标所有权保持不相交,避免全局输出原子操作;
- 规划器可以在保持逻辑 ID 的前提下重排物理行。
该机制对 PageRank、聚合以及许多 可表达为 frontier/关系/reducer 程序的 NetworkX 风格算法都很有用。高效的 BFS 与三角形计数仍需要 frontier 压缩与排序交集;目前只是路线图上的编译器诊断项,不是已完成的声明。
增量、分页与分布式执行
快照令牌把位置或边增量连接到所选的实现方式。只有在证书保持有效时, 复用才是合法的。对于有界粒子运动,未来的 Verlet 计划将跟踪最大位移,并在 skin 耗尽时重建。对于时序图,CSR 基图加增量段可以承担同样的角色,压缩 调度在关键路径之外。
把两份复用契约写出来——左边是 Verlet 的充分条件(单粒子位移小于额外邻居表半径的一半),
右边是时序图的基图加增量形式(CSR 基图 B、边插入 Δ⁺、
墓碑 Δ⁻):
%%{init: {'theme':'base', 'themeVariables': {'primaryColor':'#eef2ff','primaryBorderColor':'#4f46e5','primaryTextColor':'#312e81','lineColor':'#64748b','fontFamily':'Arial'}}}%%
flowchart LR
    S[快照 + 证书] -->|证书有效| U[复用,不重建]
    U -->|证书失效| R[重建关系]
R --> S对于大型存储图,Graph.open(...) 通过 MessagePassing 接口读取分页拓扑。
分布式执行是另一条 placement 路径:运行时先完成 halo 的打包、交换与解包,
再计算全部本地行。公开策略固定为 communication then compute,不拆分成
内部行与边界行的重叠执行。Placement 与 halo 深度是图的属性,通信由运行时管理。
单设备分页和双主机 NCCL 的结果分别列在实验中,
不代表已经验证二者组合后的分布式 offload 容量保证。
性能边界
每个动态图基准都声明自己测量的是哪条边界;基准测试结果 定义了 build-only、consume-only、build + consume 与 certified-reuse 四类边界 并报告实测用例,性能方法论定义验收规则。