用实例读懂 IR
前置内容:编译器入门。本教程从邻居加权求和出发, 沿着同一个编译器测试输入依次查看 Domain、Iter、Kernel 与 Task IR。 检查这些变换不需要 GPU。
这是编译器开发练习,不是原生 CPU 入门程序的完整执行轨迹。
原生 Tensor 程序可能直接使用 gf_tensor,详见执行路线。
1. 从计算含义开始
消息计算与下面的 Python 定义含义相同:
import tiga as tg

class WeightedAggregation(tg.MessagePassing):
    reducer = tg.sum()

    def edge(self, src, dst, edge):
        return src.x * edge.weight
源节点值乘边权,然后按目标节点求和。首页 给出了完整 Python 调用。本教程的输入是已经纳入测试的 distributed-plan.mlir: 其中还描述了 1,024 个实体、4–16 的度数范围和分区信息, 以便后面观察 task 规划。
该测试输入是手写 MLIR。下文四份可展开的完整输出都由真实编译器生成, 不是手工杜撰的架构图,也不表示每次 Python 调用都会产生这四个阶段。
2. 先读懂符号
MLIR 可以用文本表示带类型的操作。 阅读下面的片段,先掌握几个约定:
| 写法 | 含义 |
|---|---|
%x、%message |
一个值的名字;编译器打印 IR 时可能重新命名 |
@sum |
引用模块中其他位置定义的符号 |
f32、i64 |
32 位浮点数、64 位整数 |
tensor<?xf32> |
长度在运行时确定的一维浮点 Tensor |
^bb0(...) |
一个带参数的 block;这里的参数是单条边计算所需的值 |
arith.mulf |
浮点乘法 |
"gf.yield" |
从当前 region 返回消息,不是 Python generator 的 yield |
{...} / <{...}> |
属性或 property 字典;打印器可能对其位置进行规范化 |
region 包含一组操作; edge 函数体成为这样的 region。 pass 则分析或变换这些 IR。
3. Domain IR:保留消息含义
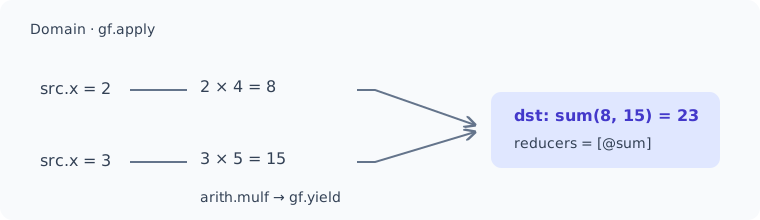
图中数值只是单行计算示意,不是下方编译器测试输入中的常量。 重点是每条边算消息,再按目标节点汇总;此时还没有指定遍历或线程安排。
下面是测试输入里的 gf.apply 操作,仅调整了换行。
图关系与 @sum 的定义保留在下方完整模块中:
%out = "gf.apply"(%relation, %x, %weight) ({
^bb0(%source: f32, %edge: f32):
  %message = arith.mulf %source, %edge : f32
  "gf.yield"(%message) : (f32) -> ()
}) {reducers = [@sum], region_kinds = array<i64: 0>,
    input_segment_sizes = array<i64: 2>,
    snapshot_versions = array<i64: 3, 3>,
    effects = ["read", "read"], deterministic = false,
    input_roles = ["src", "edge"], input_names = ["x", "weight"]
} : (!gf.relation, tensor<?xf32>, tensor<?xf32>) -> tensor<?xf32>
先看直接对应 Python 程序的部分:
%relation是图,%x与%weight是输入数组。input_roles = ["src", "edge"]将第一个数组绑定到源节点, 第二个绑定到边。%source与%edge是当前边对应的标量参数。arith.mulf保留 Python 中的乘法。reducers = [@sum]指定求和 reducer。- 版本与 effect 属性保留有效性和数据访问约束;尚未指定 GPU block 大小。
这里真实的 dialect 前缀是 gf,不是 gf.domain。
完整编译输出: domain
// Generated by tools/render_ir_docs.py; do not edit.
// Source: tests/mlir/distributed-plan.mlir
module {
  "gf.reducer"() <{associative = true, commutative = true, kind = "algebraic", message_types = [f32], result_types = [f32], state_types = [f32], sym_name = "sum"}> ({
    %cst = arith.constant 0.000000e+00 : f32
    "gf.reducer_yield"(%cst) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32):
    "gf.reducer_yield"(%arg0) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32, %arg1: f32):
    %0 = arith.addf %arg0, %arg1 : f32
    "gf.reducer_yield"(%0) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32):
    "gf.reducer_yield"(%arg0) : (f32) -> ()
  }) : () -> ()
  func.func @distributed(%arg0: tensor<?xi64>, %arg1: tensor<?xi64>, %arg2: tensor<?xf32>, %arg3: tensor<?xf32>) -> tensor<?xf32> {
    %0 = "gf.relation"(%arg0, %arg1) <{degree_max = 16 : i64, degree_min = 4 : i64, halo_depth = -1 : i64, lifecycle = "frozen", mesh_axis = 1 : i64, mesh_shape = array<i64: 2, 4>, num_dst = 1024 : i64, num_src = 1024 : i64, origin = "external", partition_balance = "edges", realization = "materialized", relation_id = "mesh", version = 3 : i64}> : (tensor<?xi64>, tensor<?xi64>) -> !gf.relation
    %1 = "gf.apply"(%0, %arg2, %arg3) <{deterministic = false, effects = ["read", "read"], input_names = ["x", "weight"], input_roles = ["src", "edge"], input_segment_sizes = array<i64: 2>, reducers = [@sum], region_kinds = array<i64: 0>, snapshot_versions = array<i64: 3, 3>}> ({
    ^bb0(%arg4: f32, %arg5: f32):
      %2 = arith.mulf %arg4, %arg5 : f32
      "gf.yield"(%2) : (f32) -> ()
    }) : (!gf.relation, tensor<?xf32>, tensor<?xf32>) -> tensor<?xf32>
    return %1 : tensor<?xf32>
  }
}
4. Iter IR:确定遍历方式
Domain 说的是“沿关系算消息、按目标节点归约”;Iter 补上的是如何枚举这批关系坐标。
gf-lower-domain-to-iter 把 gf.apply 变为 gf_iter.traverse,
但还不会展开成 GPU 线程或 for 指令。
用三个目标节点走一遍
先用一个更小的 CSR 数值例子理解遍历。
它与前面的消息公式相同,但不是下方 1,024 节点 IR fixture 的实际数据。
完整程序使用普通 torch.Tensor,运行
python examples/ir_csr_walkthrough.py。
import torch

row_ptr = torch.tensor([0, 2, 3, 3], dtype=torch.int64)
col_idx = torch.tensor([0, 1, 1], dtype=torch.int64)
x = torch.tensor([2., 3.], requires_grad=True)
weight = torch.tensor([4., 5., 2.])
row_ptr 的长度是目标节点数加一;col_idx 的每个位置是一条边,值是源节点编号。
这里有 3 个目标节点、2 个源节点、3 条边;边编号和源节点编号不是一回事。
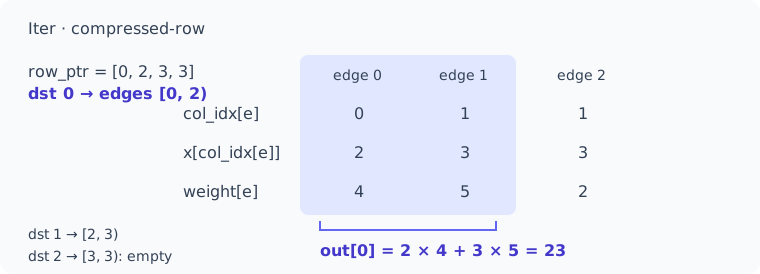
目标 i |
边区间 [row_ptr[i], row_ptr[i+1]) |
源编号 col_idx[e] |
消息及归约结果 |
|---|---|---|---|
| 0 | [0, 2),即边 0、1 |
0、1 | 2*4 + 3*5 = 23 |
| 1 | [2, 3),即边 2 |
1 | 3*2 = 6 |
| 2 | [3, 3),空行 |
无 | sum identity 为 0 |
下面是等价的解释用 Python 循环,不是编译器输出,也不是 Tiga 用户必须手写的代码:
row_ptr, col_idx = [0, 2, 3, 3], [0, 1, 1]
x, weight = [2., 3.], [4., 5., 2.]
out = []
for i in range(len(row_ptr) - 1):
    accumulator = 0.0  # @sum.identity()
    for e in range(row_ptr[i], row_ptr[i + 1]):
        j = col_idx[e]
        message = x[j] * weight[e]  # edge region
        accumulator += message    # @sum.lift / combine
    out.append(accumulator)        # @sum.finalize
assert out == [23., 6., 0.]
destination-major 表示先按目标节点分组,再遍历该行的邻居。
compressed-row 表示这些邻居由 CSR 的行偏移和列编号定位;不表示排序源编号、重建拓扑或分配 GPU block。
完整 Torch 程序
此程序在 CPU 上运行,输出 [23, 6, 0],源字段梯度为 [4, 7]。
完整源码:examples/ir_csr_walkthrough.py
"""Read destination-major CSR traversal using ordinary Torch tensors."""

import torch
import tiga as tg


class WeightedAggregation(tg.MessagePassing):
    reducer = tg.sum()

    def edge(self, src, dst, edge):
        return src.x * edge.weight


def main():
    row_ptr = torch.tensor([0, 2, 3, 3], dtype=torch.int64)
    col_idx = torch.tensor([0, 1, 1], dtype=torch.int64)
    x = torch.tensor([2., 3.], requires_grad=True)
    weight = torch.tensor([4., 5., 2.])
    graph = tg.Graph.from_csr(row_ptr, col_idx, num_src=2, validate="full")
    kernel = WeightedAggregation()
    output = kernel(graph=graph, src={"x": x}, dst={}, edge={"weight": weight})
    (gradient,) = torch.autograd.grad(output.sum(), x)
    torch.testing.assert_close(output, torch.tensor([23., 6., 0.]))
    torch.testing.assert_close(gradient, torch.tensor([4., 7.]))
    print("output:", output.tolist())
    print("d(sum(output))/dx:", gradient.tolist())
    return output, gradient


if __name__ == "__main__":
    main()
回到真实的 Iter 操作
下面摘自完整编译输出,调整换行和属性顺序,SSA 名称保持不变:
%1 = "gf_iter.traverse"(%0, %arg2, %arg3) <{
  coordinate_hierarchy = "compressed-row", ordering = "destination-major",
  reducers = [@sum], region_kinds = array<i64: 0>,
  input_segment_sizes = array<i64: 2>, snapshot_versions = array<i64: 3, 3>,
  input_roles = ["src", "edge"], input_names = ["x", "weight"],
  effects = ["read", "read"], deterministic = false
}> ({
^bb0(%arg4: f32, %arg5: f32):
  %2 = arith.mulf %arg4, %arg5 : f32
  "gf_iter.yield"(%2) : (f32) -> ()
}) : (!gf.relation, tensor<?xf32>, tensor<?xf32>) -> tensor<?xf32>
| IR 部分 | 本例中的含义 |
|---|---|
%0 |
上一条 gf.relation 的结果,包装拓扑,不是节点 0 |
%arg2 / %arg3 |
整个源字段 x / 边字段 weight 数组 |
%arg4 / %arg5 |
当前边的两个标量:x[col_idx[e]] / weight[e];不是整行数组 |
arith.mulf → gf_iter.yield |
计算并返回一条消息,不是最终目标节点的归约结果 |
reducers = [@sum] |
traverse 调用模块里的 sum algebra 汇总消息;因此 edge region 内看不到加法循环 |
%1 |
所有目标节点的输出数组;不是只返回一条边 |
region_kinds = [0]、input_segment_sizes = [2] |
一个 edge region,使用两个字段输入;没有额外的 node region |
snapshot_versions = [3,3] / effects |
两个字段的逻辑版本和读取约束;不是迭代次数或数组长度 |
deterministic = false |
没有请求固定归约顺序;destination-major 不保证浮点逐位确定性 |
此时仍没有 block_rows、warp 数或 stream;这些分别属于后面的 Kernel / Task 安排。
sum 的空行结果为 0,不能推成所有 reducer 的空行结果都为 0。
不同关系怎样遍历?
当前 pass 按关系种类选择坐标组织,不是所有图都变成 CSR:
| 关系 | coordinate_hierarchy |
枚举方式 |
|---|---|---|
| 已物化 CSR | compressed-row |
从行区间读取已有边 |
| dense / triangular | cartesian-product |
枚举源与目标组合,保留关系的边界条件 |
| generated radius | generated-neighborhood |
按邻域生成规则筛选候选坐标 |
| ranked kNN | ranked-pairs |
按排名选择关系坐标 |
这是该 pass 的分类,不是所有 provider 都能执行的承诺。分页关系在此 pass 中保留 Domain IR,
不是强行改为 compressed-row。实现与校验规则分别见
LowerDomainToIter.cpp
和 IterOps.cpp。
完整编译输出: iter
// Generated by tools/render_ir_docs.py; do not edit.
// Source: tests/mlir/distributed-plan.mlir
module {
  "gf.reducer"() <{associative = true, commutative = true, kind = "algebraic", message_types = [f32], result_types = [f32], state_types = [f32], sym_name = "sum"}> ({
    %cst = arith.constant 0.000000e+00 : f32
    "gf.reducer_yield"(%cst) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32):
    "gf.reducer_yield"(%arg0) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32, %arg1: f32):
    %0 = arith.addf %arg0, %arg1 : f32
    "gf.reducer_yield"(%0) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32):
    "gf.reducer_yield"(%arg0) : (f32) -> ()
  }) : () -> ()
  func.func @distributed(%arg0: tensor<?xi64>, %arg1: tensor<?xi64>, %arg2: tensor<?xf32>, %arg3: tensor<?xf32>) -> tensor<?xf32> {
    %0 = "gf.relation"(%arg0, %arg1) <{degree_max = 16 : i64, degree_min = 4 : i64, halo_depth = -1 : i64, lifecycle = "frozen", mesh_axis = 1 : i64, mesh_shape = array<i64: 2, 4>, num_dst = 1024 : i64, num_src = 1024 : i64, origin = "external", partition_balance = "edges", realization = "materialized", relation_id = "mesh", version = 3 : i64}> : (tensor<?xi64>, tensor<?xi64>) -> !gf.relation
    %1 = "gf_iter.traverse"(%0, %arg2, %arg3) <{coordinate_hierarchy = "compressed-row", deterministic = false, effects = ["read", "read"], input_names = ["x", "weight"], input_roles = ["src", "edge"], input_segment_sizes = array<i64: 2>, ordering = "destination-major", reducers = [@sum], region_kinds = array<i64: 0>, snapshot_versions = array<i64: 3, 3>}> ({
    ^bb0(%arg4: f32, %arg5: f32):
      %2 = arith.mulf %arg4, %arg5 : f32
      "gf_iter.yield"(%2) : (f32) -> ()
    }) : (!gf.relation, tensor<?xf32>, tensor<?xf32>) -> tensor<?xf32>
    return %1 : tensor<?xf32>
  }
}
5. Kernel IR:确定执行安排
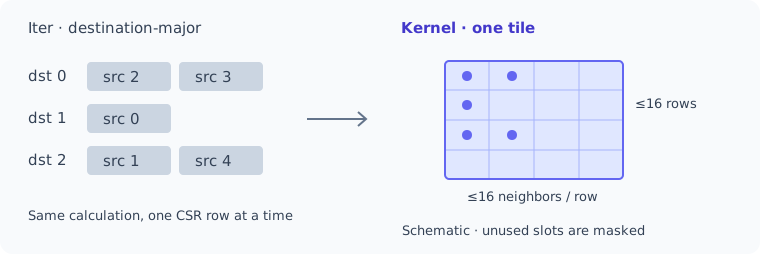
左边回答“按什么顺序遍历”,右边回答“哪些工作分在同一个 tile”。 格子是缩略示意,不是完整的 16 × 16 网格,也不表示一格对应一个线程。
后续 pass 将遍历变为 gf_kernel.launch,并选择 schedule。
这个测试输入产生了以下属性:
traversal = "csr-row"
schedule_kind = "bounded-ragged-row-neighbor"
block_rows = 16 : i64
block_neighbors = 16 : i64
num_warps = 4 : i64
pipeline_stages = 1 : i64
kernel 已携带工作分组与资源契约。 行和邻居的 tile 范围来自当前测试输入的执行计划,不是所有程序的默认值,也不是用户手写的参数。 之后还需要生成目标代码。
完整编译输出: kernel
// Generated by tools/render_ir_docs.py; do not edit.
// Source: tests/mlir/distributed-plan.mlir
module {
  "gf.reducer"() <{associative = true, commutative = true, kind = "algebraic", message_types = [f32], result_types = [f32], state_types = [f32], sym_name = "sum"}> ({
    %cst = arith.constant 0.000000e+00 : f32
    "gf.reducer_yield"(%cst) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32):
    "gf.reducer_yield"(%arg0) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32, %arg1: f32):
    %0 = arith.addf %arg0, %arg1 : f32
    "gf.reducer_yield"(%0) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32):
    "gf.reducer_yield"(%arg0) : (f32) -> ()
  }) : () -> ()
  func.func @distributed(%arg0: tensor<?xi64>, %arg1: tensor<?xi64>, %arg2: tensor<?xf32>, %arg3: tensor<?xf32>) -> tensor<?xf32> {
    %0 = "gf.relation"(%arg0, %arg1) <{degree_max = 16 : i64, degree_min = 4 : i64, halo_depth = -1 : i64, lifecycle = "frozen", mesh_axis = 1 : i64, mesh_shape = array<i64: 2, 4>, num_dst = 1024 : i64, num_src = 1024 : i64, origin = "external", partition_balance = "edges", realization = "materialized", relation_id = "mesh", version = 3 : i64}> : (tensor<?xi64>, tensor<?xi64>) -> !gf.relation
    %1 = "gf_kernel.launch"(%arg0, %arg1, %arg2, %arg3) <{block_neighbors = 16 : i64, block_rows = 16 : i64, degree_max = 16 : i64, degree_min = 4 : i64, deterministic = false, effects = ["read", "read"], execution_roles = ["workgroup.destination-rows", "subgroup.neighbor-reduction", "lane.scalar"], input_names = ["x", "weight"], input_roles = ["src", "edge"], input_segment_sizes = array<i64: 2>, instruction_contracts = ["masked-memory", "associative-reduce"], num_rows = 1024 : i64, num_warps = 4 : i64, pipeline_stages = 1 : i64, reducers = [@sum], region_kinds = array<i64: 0>, schedule_handoffs = ["load.global-to-register", "reduce.subgroup", "store.register-to-global"], schedule_kind = "bounded-ragged-row-neighbor", schedule_resources = ["relation.global.read", "input.global.read", "state.register.private", "output.global.write"], snapshot_versions = array<i64: 3, 3>, target_contract = "provider-neutral-v1", traversal = "csr-row"}> ({
    ^bb0(%arg4: f32, %arg5: f32):
      %2 = arith.mulf %arg4, %arg5 : f32
      "gf_kernel.yield"(%2) : (f32) -> ()
    }) : (tensor<?xi64>, tensor<?xi64>, tensor<?xf32>, tensor<?xf32>) -> tensor<?xf32>
    return %1 : tensor<?xf32>
  }
}
6. Task IR:表达执行依赖
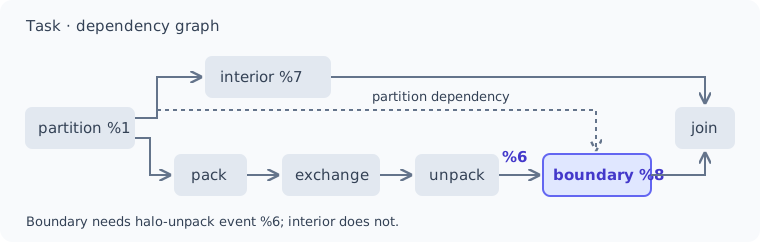
箭头表示依赖,不是耗时比例。boundary 必须等待 halo 数据, 而 interior 不依赖该事件。此编译器测试输入用于展示依赖表示;公开分布式 runtime 使用先通信再计算的顺序。
因为这个输入带有分区信息,gf-plan-distributed-tasks pass 增加了 partition、
halo 交换计划与任务依赖。
下面两条真实操作展示其区别,仅调整换行:
%7 = "gf_task.launch"(%1) <{
  callee = @distributed, operandSegmentSizes = array<i32: 1, 0>,
  reads = ["x"], snapshot_version = 3 : i64,
  task_kind = "interior", writes = ["out"]
}> : (!gf_task.partition) -> !gf_storage.event

%8 = "gf_task.launch"(%1, %6) <{
  callee = @distributed, operandSegmentSizes = array<i32: 1, 1>,
  reads = ["x"], snapshot_version = 3 : i64,
  task_kind = "boundary", writes = ["out"]
}> : (!gf_task.partition, !gf_storage.event) -> !gf_storage.event
%1 是分区,%6 是 halo unpack 产生的事件:
- interior 计算只依赖分区与本地数据。
- boundary 计算额外接收
%6,因此需要等待 halo 数据。 gf_storage.join汇合两类计算的完成事件。gf_kernel.launch仍然携带消息计算;task 规划不会把乘法“换成通信”。
这是 IR 规划测试,不会启动真实的多 GPU 任务,也不能证明通信与计算已经重叠。 没有这些放置要求的简单程序,不必产生上述 task。
完整编译输出: task
// Generated by tools/render_ir_docs.py; do not edit.
// Source: tests/mlir/distributed-plan.mlir
module {
  "gf.reducer"() <{associative = true, commutative = true, kind = "algebraic", message_types = [f32], result_types = [f32], state_types = [f32], sym_name = "sum"}> ({
    %cst = arith.constant 0.000000e+00 : f32
    "gf.reducer_yield"(%cst) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32):
    "gf.reducer_yield"(%arg0) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32, %arg1: f32):
    %0 = arith.addf %arg0, %arg1 : f32
    "gf.reducer_yield"(%0) : (f32) -> ()
  }, {
  ^bb0(%arg0: f32):
    "gf.reducer_yield"(%arg0) : (f32) -> ()
  }) : () -> ()
  func.func @distributed(%arg0: tensor<?xi64>, %arg1: tensor<?xi64>, %arg2: tensor<?xf32>, %arg3: tensor<?xf32>) -> tensor<?xf32> {
    %0 = "gf.relation"(%arg0, %arg1) <{degree_max = 16 : i64, degree_min = 4 : i64, halo_depth = -1 : i64, lifecycle = "frozen", mesh_axis = 1 : i64, mesh_shape = array<i64: 2, 4>, num_dst = 1024 : i64, num_src = 1024 : i64, origin = "external", partition_balance = "edges", realization = "materialized", relation_id = "mesh", version = 3 : i64}> : (tensor<?xi64>, tensor<?xi64>) -> !gf.relation
    %1 = "gf_task.partition"(%0) <{ghost_entities = -1 : i64, mesh_axis = 1 : i64, mesh_shape = array<i64: 2, 4>, owned_entities = 256 : i64, scheme = "destination", version = 3 : i64}> {ghost_map_algorithm = "csr-owned-row-remote-src-sort-unique", neighbor_discovery = "alltoall-counts-then-request-ids", owner_map_algorithm = "contiguous-destination-prefix"} : (!gf.relation) -> !gf_task.partition
    %2 = "gf_task.halo"(%1) <{depth = -1 : i64, fields = ["x"], strategy = "auto"}> : (!gf_task.partition) -> !gf_task.halo_plan
    %3 = "gf_storage.region"(%arg2) <{elements = 1024 : i64, logical_id = "x", version = 3 : i64}> : (tensor<?xf32>) -> !gf_storage.region
    %4 = "gf_storage.instance"(%3) <{capacity_bytes = 1024 : i64, device = "local", external = true, layout = "partitioned", memory_space = "device"}> : (!gf_storage.region) -> !gf_storage.instance
    %5 = "gf_storage.instance"(%3) <{capacity_bytes = 3072 : i64, device = "ghost", external = true, layout = "partitioned", memory_space = "device"}> : (!gf_storage.region) -> !gf_storage.instance
    %send, %done = "gf_task.halo_pack"(%2, %4) <{bytes = 3072 : i64, field = "x", snapshot_version = 3 : i64}> : (!gf_task.halo_plan, !gf_storage.instance) -> (!gf_task.halo_buffer, !gf_storage.event)
    %receive, %done_0 = "gf_task.halo_exchange"(%2, %send, %done) <{bytes = 3072 : i64, group = "mesh", snapshot_version = 3 : i64}> : (!gf_task.halo_plan, !gf_task.halo_buffer, !gf_storage.event) -> (!gf_task.halo_buffer, !gf_storage.event)
    %6 = "gf_task.halo_unpack"(%2, %receive, %5, %done_0) <{field = "x", snapshot_version = 3 : i64}> : (!gf_task.halo_plan, !gf_task.halo_buffer, !gf_storage.instance, !gf_storage.event) -> !gf_storage.event
    %7 = "gf_task.launch"(%1) <{callee = @distributed, operandSegmentSizes = array<i32: 1, 0>, reads = ["x"], snapshot_version = 3 : i64, task_kind = "interior", writes = ["out"]}> : (!gf_task.partition) -> !gf_storage.event
    %8 = "gf_task.launch"(%1, %6) <{callee = @distributed, operandSegmentSizes = array<i32: 1, 1>, reads = ["x"], snapshot_version = 3 : i64, task_kind = "boundary", writes = ["out"]}> : (!gf_task.partition, !gf_storage.event) -> !gf_storage.event
    %9 = "gf_storage.join"(%7, %8) <{snapshot_version = 3 : i64}> : (!gf_storage.event, !gf_storage.event) -> !gf_storage.event
    %10 = "gf_kernel.launch"(%arg0, %arg1, %arg2, %arg3) <{block_neighbors = 16 : i64, block_rows = 16 : i64, degree_max = 16 : i64, degree_min = 4 : i64, deterministic = false, effects = ["read", "read"], execution_roles = ["workgroup.destination-rows", "subgroup.neighbor-reduction", "lane.scalar"], input_names = ["x", "weight"], input_roles = ["src", "edge"], input_segment_sizes = array<i64: 2>, instruction_contracts = ["masked-memory", "associative-reduce"], num_rows = 1024 : i64, num_warps = 4 : i64, pipeline_stages = 1 : i64, reducers = [@sum], region_kinds = array<i64: 0>, schedule_handoffs = ["load.global-to-register", "reduce.subgroup", "store.register-to-global"], schedule_kind = "bounded-ragged-row-neighbor", schedule_resources = ["relation.global.read", "input.global.read", "state.register.private", "output.global.write"], snapshot_versions = array<i64: 3, 3>, target_contract = "provider-neutral-v1", traversal = "csr-row"}> ({
    ^bb0(%arg4: f32, %arg5: f32):
      %11 = arith.mulf %arg4, %arg5 : f32
      "gf_kernel.yield"(%11) : (f32) -> ()
    }) {gf_task.planned} : (tensor<?xi64>, tensor<?xi64>, tensor<?xf32>, tensor<?xf32>) -> tensor<?xf32>
    return %10 : tensor<?xf32>
  }
}
7. 复现输出
先完成编译器测试构建,再从仓库根目录执行:
export TIGA_OPT="$PWD/build/compiler/bin/gf-opt"

"$TIGA_OPT" tests/mlir/distributed-plan.mlir

"$TIGA_OPT" tests/mlir/distributed-plan.mlir \
  -gf-lower-domain-to-iter

"$TIGA_OPT" tests/mlir/distributed-plan.mlir \
  -gf-lower-domain-to-iter -gf-lower-iter-to-kernel \
  -gf-select-kernel-schedule

"$TIGA_OPT" tests/mlir/distributed-plan.mlir \
  -gf-lower-domain-to-iter -gf-lower-iter-to-kernel \
  -gf-select-kernel-schedule -gf-plan-distributed-tasks
文档快照会与实际编译输出比对:
有意修改编译器后,去掉 --check 重新生成快照,检查差异,再构建文档。
源码测试
也会验证 halo 与 task 的结构。