性能、容量与分布式执行
对比执行时间与内存开销,评估单 GPU 的十亿边容量,并分析分布式通信开销。 测量记录于 2026 年 9 月 19 日,同时呈现加速与减速结果。 全部是 FP32 前向,不是完整训练迭代。历史 benchmark 归档。
下载原始数据、源码与 profiler trace · 复现协议
窄屏可横向滑动图表,或点击打开完整原图。
运行性能与显存开销
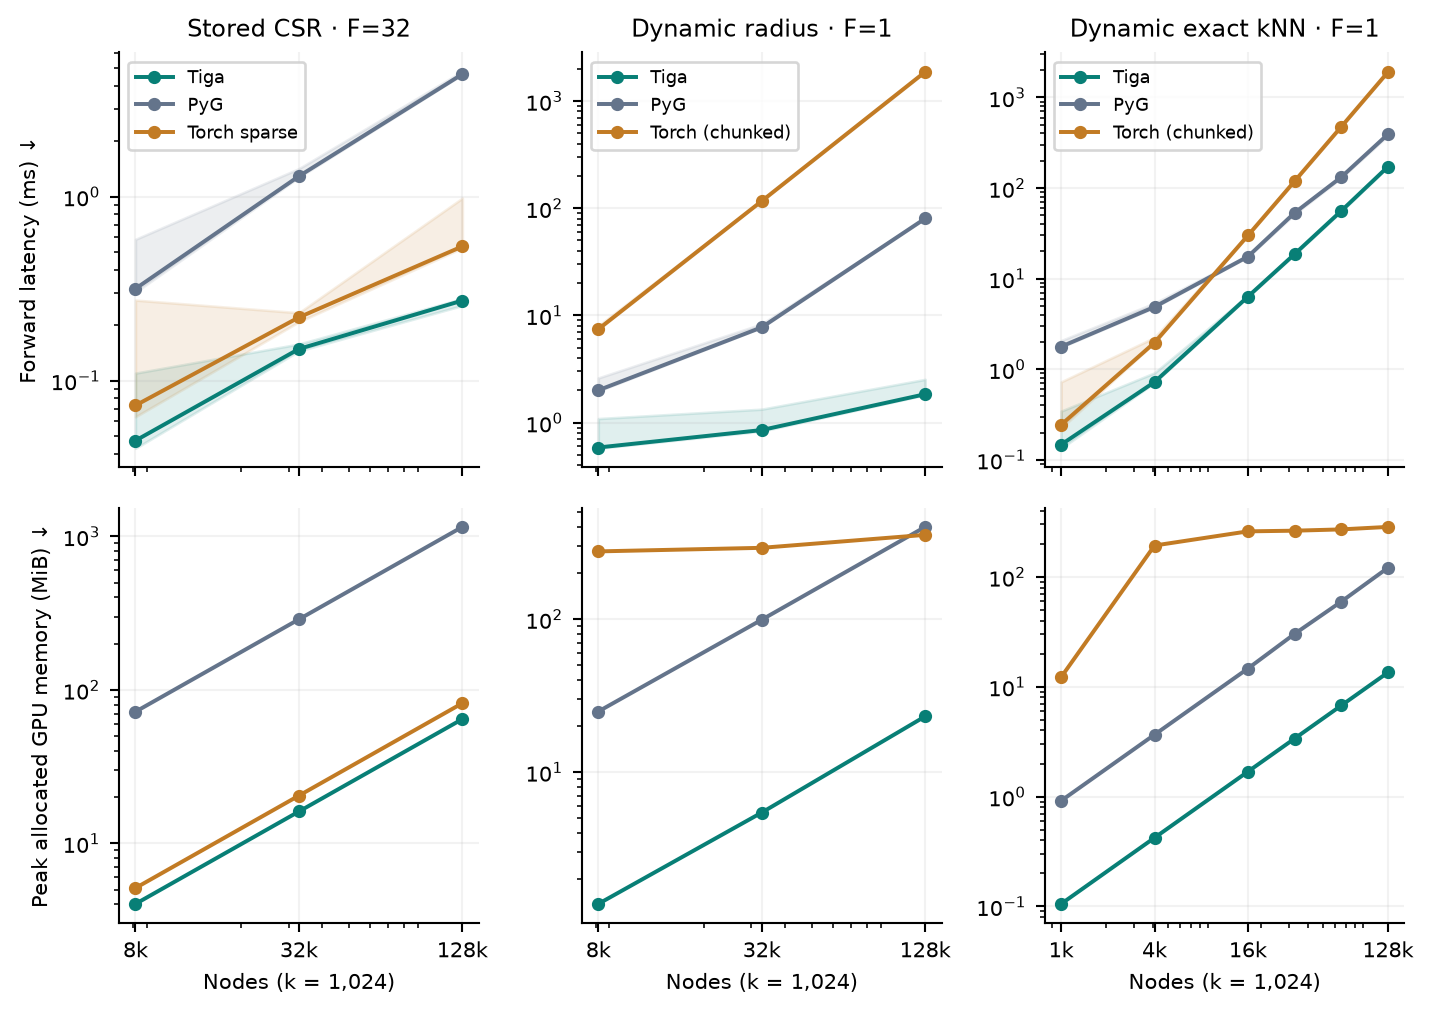
上排是完整调用耗时,下排是实测峰值分配显存,均为越低越好;坐标轴采用对数刻度。 三列是不同工作负载,不能把它们合成一个综合分数。
| 各工作负载的最大测量点 | Tiga / 对照耗时 | Tiga / 对照显存分配 |
|---|---|---|
| 已有 CSR,131,072 节点、32 features;对照 Torch sparse | 0.272 / 0.536 ms | 64.50 / 81.83 MiB |
| 动态 radius,131,072 点、标量 features;对照 PyG | 1.84 / 80.24 ms | 23.14 / 400.22 MiB |
| 精确 kNN,131,072 点、标量 features;对照 PyG | 172.37 / 393.21 ms | 13.50 / 121.13 MiB |
已有 CSR 的三个测量点相对 Torch sparse 加速 1.49–1.97×,显存分配约降低至其 1/1.27。radius 在这组数据上同时更快、更省显存。加入按语义复用 executable 和精确 tile selection 剪枝后,kNN 在 1,024–131,072 点的六个规模上相对实测 PyG 路径 加速 2.28–12.06×。最大规模快 2.28×,分配显存约为 PyG 的九分之一。 每次仍从变化后的坐标重新搜索邻居,不是复用旧邻居结果。
动态实验每轮交替使用两套真正不同的坐标,计时包含坐标复制、邻居搜索和聚合。 计时前逐一核对完整邻居集合,每个测量输出也都核对。radius 使用二进制坐标网格, cutoff 位于距离平方的相邻离散值之间,避免浮点边界歧义;邻居数上限已验证没有截断。 共 36 个配置,每个在独立进程中预热四次、测量十次;阴影表示样本最小值到最大值, 不是跨独立进程的置信区间。
PyG 曲线表示其 builder 加 COO MessagePassing 路径,不代表 PyG 的所有优化。
CSR 列同时包含 torch.sparse.mm。图例 Torch (chunked) 表示完整的纯 Torch
建图与聚合,不调用 Tiga/PyG builder:分块计算直接距离平方后,kNN 做 top-k、gather
和 sum;radius 构建 CSR 后做 torch.sparse.mm。每个距离块最多包含 16,777,216
个点对,中间可能同时存在多个张量,因此 128K 点不必分配 64 GiB 的完整距离矩阵。
最大规模的 Torch kNN 为 1,908.43 ms / 285.00 MiB,radius 为 1,870.09 ms /
355.01 MiB。这些是全点对参考实现,不是经过优化的空间索引算法。
动态生成路径测的是单 feature,不能直接推广到宽 feature 的 edge network。
显存统计包括存活输入、输出和临时张量,不包括 allocator reserve、CUDA context/module
及其他进程。三个最大配置的独立审计均未发现额外 Tiga-native device buffer 分配。
每项测量对应的源码版本、原始采样与配置均包含在页面顶部的数据归档中。
十亿边单 GPU 执行
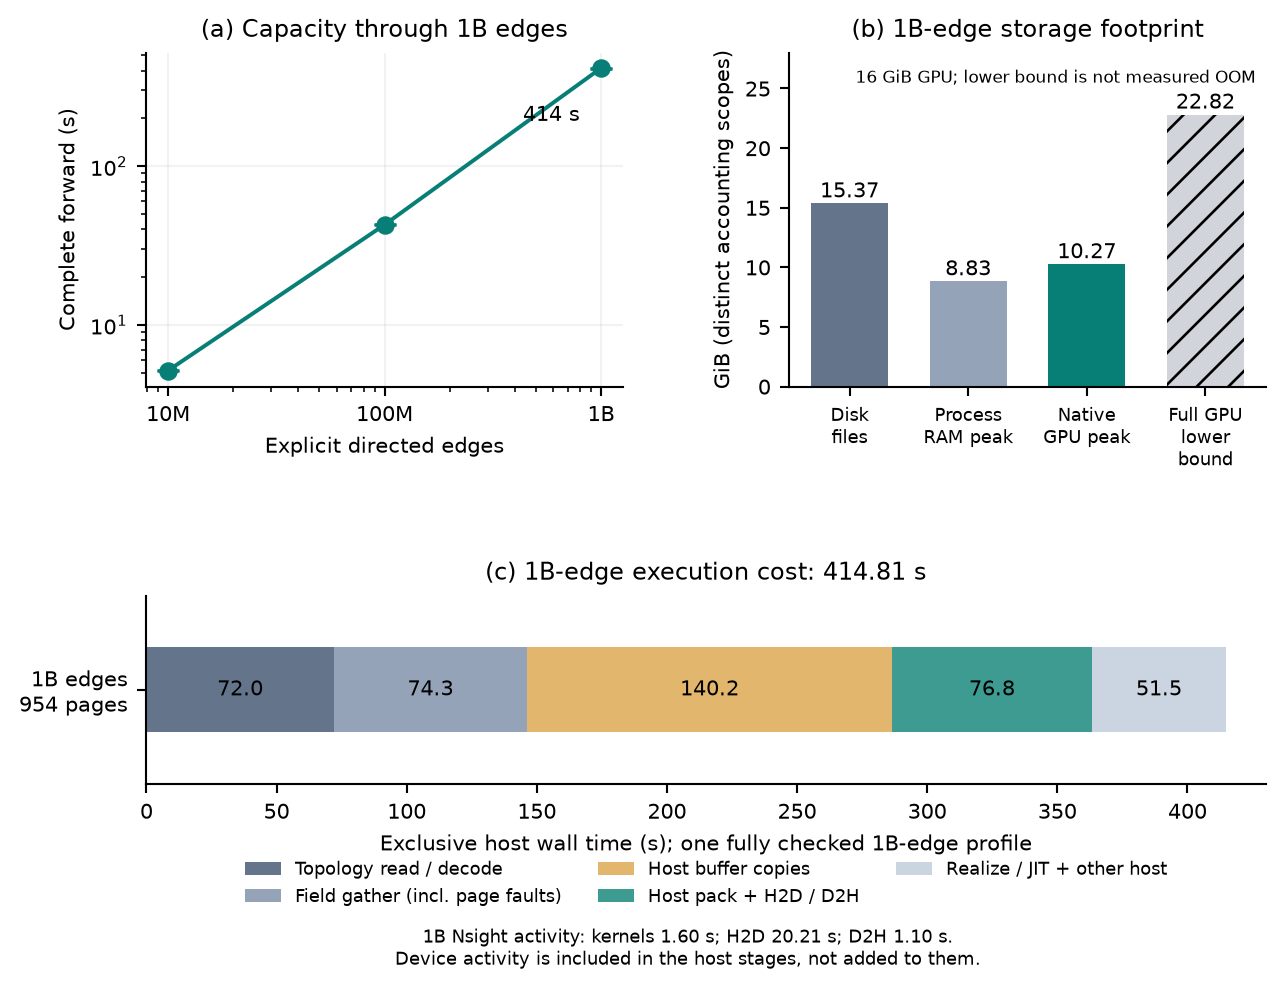
16 GiB RTX 5070 Ti 上,1B 条显式有向边在 414.25 秒内完成前向。 三次独立进程的范围为 411.36–415.61 秒,全部 20 亿个输出标量通过独立 oracle 的精确核对。 1B 是最大实测规模,不是已证明的绝对上限。
| 1B edges 的资源占用 | 数值 | 含义 |
|---|---|---|
| Disk | 15.37 GiB | 已存储的拓扑与源 features |
| RAM | 8.83 GiB | 前向期间进程 RSS 峰值,包含映射页面 |
| GPU | 10.27 GiB | native 跟踪的分配峰值,不是整卡物理占用 |
| 全量驻留要求 | 22.82 GiB | CSR、源 features 和输出的计算下界,不是实测 OOM |
每行 16 个邻居,32 个 FP32 features;每页包含 65,536 个目标节点。
该 benchmark 显式设置 prefetch=False,属于串行容量基线,并非 compiler 自动调度的
异步 IO 测量。runtime 的可选 prefetch 只提前读取拓扑页并发出连续字段预读提示,
没有把 source gather、GPU staging 和输出组装串成完整的双缓冲流水线。
输出仍完整保留在 GPU,占用 7.45 GiB。包含已有服务及分配池的整卡采样峰值是
13.25 GiB。这两张消费级 GPU 使用 GDDR 显存,不是 HBM。
图下方是 1B edges 执行的 profiling,之后完整核对全部 20 亿个输出标量。 测量窗口为 414.81 秒;包含 profiler 启停的外层调用为 417.05 秒。 该独立 instrumented call 不混入上方三次容量实验的中位数。 Nsight 记录 GPU kernel 为 1.60 秒, H2D 为 20.21 秒,D2H 为 1.10 秒。互不重叠的 host 阶段分别是: 拓扑读取/解码 71.98 秒、字段 gather 74.27 秒、缓冲区复制 140.22 秒、 打包及传输 76.79 秒、realize/设置/组装 51.55 秒。
当前 staging 把 8 GB 的源字段展开成 128 GB gather 数据,总 H2D 流量为 144.50 GB。 仅对测试文件发出缓存释放提示后,进程物理读取量为 16.50 GB。 host 阶段包含 page fault 和传输,不是纯磁盘服务时间;GPU 活动已经包含在其中, 不能再次相加。数据集能放进 RAM;耗时分解是在 1B 边上实测,不是从小图外推。
全量驻留需求是容量计算下界;其他实现的 OOM 与手工分块对照未测量。 该结果不涵盖 CUDA paged backward、1B 递推和输出 offload。
分布式执行与通信开销
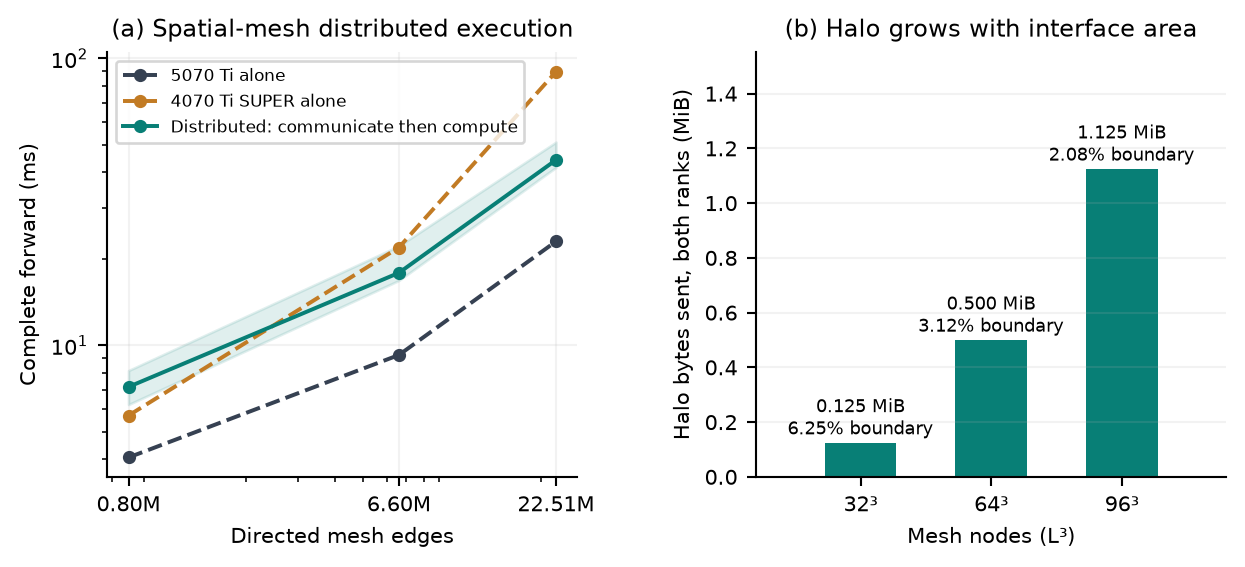
输入采用非周期三维六面体空间网格:共享单元的不同节点之间双向连接,内部节点有 26 个邻居。这是 FEM 类型的连接关系,测量的是 16-feature 邻居求和,不是完整 FEM 求解器。立方体边长为 32、64、96,最大为 884,736 节点、22,508,920 条有向边。
RTX 5070 Ti 与 RTX 4070 Ti SUPER 沿空间平面切分,各持有一半目标节点,通过 halo 交换远端源 features。 边长为 L 时,计算量随体积增长,halo 随分界面面积增长:
边界比例依次为 6.25%、3.125%、2.083%,双 rank 总发送量为 0.125、0.500、1.125 MiB。 这些值已与实际传输记录及 runtime trace 核对。这里是两个 rank 的图分区并行, 不是沿 feature 维度切分的 tensor parallelism。
每次执行先交换 halo,再计算本地输出。图中对比双卡分区执行与两张卡各自运行完整图的耗时。
在 2,250.89 万条边上,5070 Ti 单独计算完整图为 23.00 ms,4070 Ti SUPER 为 89.75 ms;双卡先通信再计算为 44.22 ms。 此配置下,双卡耗时介于两张卡单独执行之间;相对 5070 Ti 单卡约慢 1.92 倍。
测量配置
| 项目 | 配置 |
|---|---|
| 设备与分区 | RTX 5070 Ti + RTX 4070 Ti SUPER;沿空间平面等分目标节点,固定分区 |
| 通信 | 跨主机 NCCL Socket;完整网络配置见复现协议 |
| 计时范围 | 一次完整前向调用,包含 halo 交换、runtime 调度、计算与同步等待 |
| 汇总方式 | 每轮取两个 rank 完成时间的最大值,再对五轮取中位数 |
| 采样 | 预热两次、测量五次;每轮改变输入并核对完整输出 |
| 拓扑与显存 | 两端各存完整拓扑,初始化不计时;本实验评估执行耗时,不测量合并显存容量 |
分区与启动方法见内存与分布式执行。