内存层级与分布式执行
普通程序使用内存与存储入口;本页介绍编译器侧的 memory hierarchy 与分布式执行机制。
当前边界
原生 Tensor 的 LRU 换出、编译器物理实例与图分页分别管理 ownership 和预算。CUDA 分页支持 FP32 前向,使用 host staging 和驻留输出;分页 backward 仅支持 CPU。分布式 TCP/NCCL 支持前向/VJP,先通信再计算。完整覆盖范围见支持矩阵,工作负载结果见性能测量。
内存层级
一个逻辑值可以有多个显式管理的物理实例。HierarchyRuntime 跟踪逻辑名、版本、容量和完成状态,不会自动把所有公开 Tensor 转成这些实例。
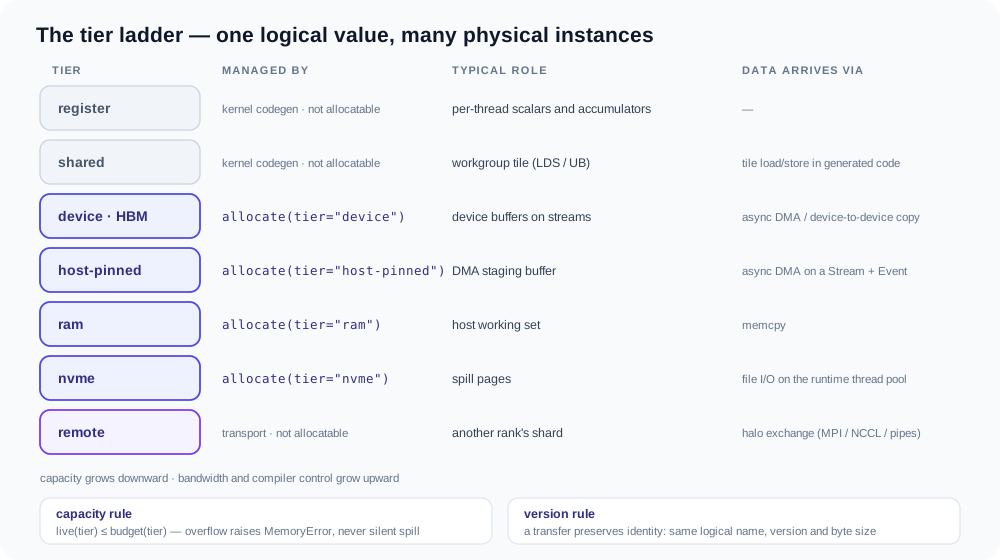
Register/shared 存储由生成的 kernel 管理;device、host-pinned、ram、nvme 可由 runtime 分配。remote 属于 transport,不是本地可分配的 buffer。
容量与版本记账
实例分配检查所属 runtime 的逐层预算;原生 buffer 与临时 NVMe 实例还参与活跃 tg.execution 的记账。这是两种范围的检查,不是同一统计里重复收费;容量不是进程 RSS。
Transfer 要求逻辑名、版本和容量一致,返回带 .ready / .wait() 的完成句柄。关闭源实例时先等待未完成的读取;重写目标也先等待其已有读取。latest(name) 选择存活实例中的最高版本,同版本副本没有隐含的层级优先顺序。
下面是完整 CPU 例子,经 NVMe 搬运八字节并验证往返:
import tiga as tg

with tg.runtime.HierarchyRuntime(budgets={"ram": 16, "nvme": 8}) as rt:
    hot = rt.allocate("state", 7, tier="ram", capacity_bytes=8)
    hot.buffer.write(b"tiga1234")
    cold = rt.allocate("state", 7, tier="nvme", capacity_bytes=8)
    rt.transfer(hot, cold).wait()
    hot.close()
    back = rt.allocate("state", 7, tier="ram", capacity_bytes=8)
    rt.transfer(cold, back).wait()
    assert back.buffer.read() == b"tiga1234"
这个 runtime 作用域拥有物理实例,退出时关闭它们;execution 策略作用域则不会使返回的公开 Tensor 失效。RAM↔NVMe 按有界块搬运,设备拷贝使用原生 stream/event 定序。目前不存在为任意程序自动插入完整 spill/reload 决策的编译器调度。
编译器打包计划
runtime 之上是编译器的物理计划:ExecutableBundlePlan 是一份经过校验的调用
DAG 加上一组
ResourceRequirement(名称、内存空间、容量、快照版本)。
allocate_hierarchy(runtime) 把需求映射到各层实例,三个保留符号为计划提供显式的
存储控制:__gf_transfer(跨层移动)、__gf_release(关闭实例)和 __gf_join。
合法性规则值得直说:每一次写/写或读/写冲突都必须由显式依赖定序, 除非两次访问通过同一分区被证明不相交——runtime 绝不会凭空发明依赖。 违反此规则的 bundle 在构造时即被拒绝,而不是在一次数据损坏的运行之后再去调试。
分布式执行
分布式图仍然是普通的 Graph。graph.halo(mesh, ...)
只是附加声明式放置——没有数据移动,也不出现 subtype:
mesh = tg.DeviceMesh("cuda", (2, 4), names=("rack", "gpu"))
graph = graph.halo(mesh, partition=tg.ByDestination(mesh_axis="gpu"), depth="auto")
精确定义:owned 与 ghost
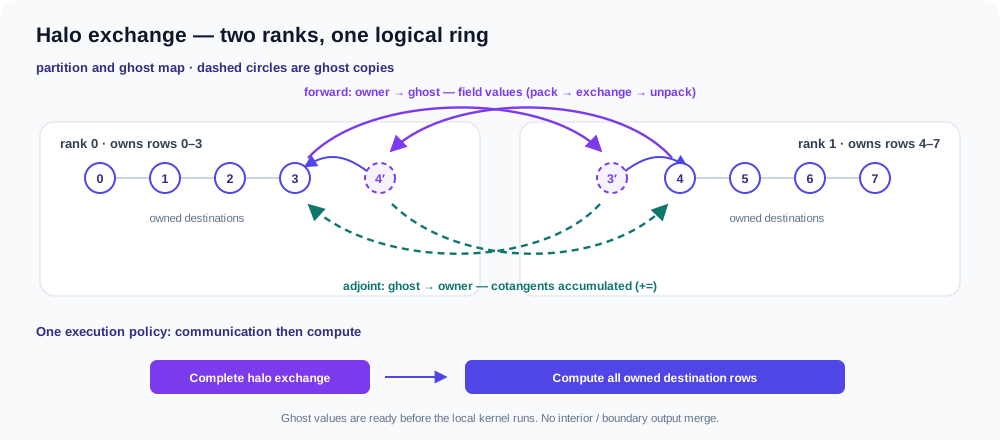
设有 N 个目标实体和 W 个 rank,默认的均衡分区把连续的行区间分给
rank r:
ghost 集合由关系推导而来,而非声明:
derive_halo_map 仅凭 owned 的 CSR 行按 rank 计算出该集合;对于分页
.gfg 存储,每个 rank 只读取自己的行区间,因此任何 rank 都不会物化
全局邻接结构。
前向:先通信,再计算
分布式前向按以下顺序执行:
- 打包并交换 halo,将数值从 owner 传到 ghost。
- 等待远端源数据就绪。
- 一次本地调用计算全部 owned 目标行。
全部 owned 行写入同一份本地输出。Graph 和 edge function 无需调度选项。 CPU、MPI、TCP 和 NCCL 遵循同一依赖顺序, transport 选择只影响数据传输方式。
每次调用记录 DistributedRuntime.last_execution_trace(schema
tiga.distributed-execution-trace.v1)。调度名为
host-staged-serialized 或 device-direct-serialized,
interior_rows=0、measured_overlap_ms=0。
反向:伴随同样是一次 halo 交换
前向把每个组合后的源字段包装为 distributed_halo_snapshot
叶子节点,生成的 VJP 无需用户代码就知道反向通信模式:ghost 的余切
被送回其 owner,并累积进 owned 行——
这正是前向 owner→ghost gather 的伴随。 distributed halo 示例 在一个 8 节点环上端到端验证了这一点:每个 rank 的本地梯度均为 3, 包括跨越 rank 边界的贡献。
两台机器上的 CUDA sanity check
multi_host_gpu_gate.py 核对两个 rank 的前向、VJP 和输入变化后的重复调用。分别从两台机器的仓库根目录运行:
# Host A: 使用 A 的可达内网地址
PYTHONPATH=python python benchmarks/distributed/multi_host_gpu_gate.py \
  --rank 0 --host 192.168.1.10 --port 29570 --device cuda:0 --output output/rank0.json

# Host B: 同样连接 A,每台机器的本地设备序号都可以是 cuda:0
PYTHONPATH=python python benchmarks/distributed/multi_host_gpu_gate.py \
  --rank 1 --host 192.168.1.10 --port 29570 --device cuda:0 --output output/rank1.json
两份结果均须 correct=true。两端需要相同源码、已构建的编译器和兼容的 Triton、CUDA,
可使用不同 GPU 架构。全局 rank 标识参与进程,本地 CUDA 序号选择该进程使用的 GPU。
运行时间与分区规模的对比见分布式性能测量。
这条路径自动派生 halo,并固定先通信再计算;不会自动发现机器、启动远程进程或按显卡速度重新平衡分区。TCP 使用 host-staged 数据,非 NCCL/GPU-direct;原 transport 的对象消息含 pickle,只可连接可信内网 peer。timeout 同时限制建连和数据等待;对冷 JIT 留出充足时间。超过两 rank 的 full-mesh 要求对应监听端口互通。
两台机器上的 NCCL
使用 --transport nccl 检查 NCCL 路径的图计算前向、VJP 和重复调用。
启动时通过 TCP 分发 communicator ID,随后由 NCCL 交换 device buffer。
仅检查双向 1 MiB 数据交换时,运行
NCCL probe。
以下命令选择 Socket 通信;将 INTERFACE 替换为双方可达的网络接口,
HOST 替换为 rank 0 的地址:
# 两台机器分别使用 RANK=0/1,共用可达的 HOST 地址。
NCCL_SOCKET_IFNAME=INTERFACE NCCL_SOCKET_FAMILY=AF_INET NCCL_IB_DISABLE=1 \
  PYTHONPATH=python timeout 90s python benchmarks/distributed/multi_host_gpu_gate.py \
  --rank RANK --host HOST --port 29659 --transport nccl --output rank-RANK.json
两份结果均须 correct=true,且源码与 NCCL library hash 一致。
使用启动超时限制初始化等待;transport 端口仅向可信 peer 开放。
Runtime 与 transport
通信属于 runtime 执行阶段,与本地 kernel 编译分开。CPU halo VJP 先物化余切、 交换梯度贡献,再作为后续 LLVM kernel 的输入;强制 native 模式也遵循这一边界。 梯度物化结束前,runtime 必须保持活跃。
绑定 runtime
执行要求有活跃的 runtime;没有 runtime 时调用分布式图会
fail closed(NotImplementedError):
with tg.distributed.DistributedRuntime(transport):
    out = Diffusion()(graph=graph, src={"u": local_u}, dst={"u": local_u})
transport 是进程初始化时选定的部署插件——kernel 与图代码从不指名任何一个:
PipeTransport——标准库multiprocessing管道(示例与双进程测试使用);TCPTransport/from_provider("tcp")——零依赖的跨机 transport,基于纯 socket(rendezvous 注册、rank 握手、带帧数据流);DistributedRuntime.from_provider("mpi")——一个轻薄的 mpi4py 封装;from_provider("nccl", rank=..., world_size=..., communicator_id=..., ...)绑定真实的libnccl通信器(仅分组 send/recv;rank 0 创建 128 字节的ncclUniqueId,由启动器广播);- 第三方通过
tiga.transportentry-point 组注册。
持久化拓扑保持同一套 API:tg.save(graph, "mesh.gfg") 写入带版本的分页存储
(manifest + row_ptr.bin + col_idx.bin),
tg.load("mesh.gfg").halo(mesh, depth="auto") 回到同一个分区快照,
每个 rank 只读取自己的页。tg.load 只读取 manifest;resolve_csr()
仍是显式的调试物化。
这些路径的实测 transfer、halo 交换、重叠与 NCCL 证据汇总在 基准测试结果 页面。